Аудит сайта для LLM и AI Search: что проверять для генеративного поиска
Два пути генеративного сервиса к тексту — с обращением к сайту и без него — проверяются разным. Разрыв между индексируемостью и пригодностью к цитате, что видно со стороны сайта, что со стороны ответа и чего такая проверка не обещает.

Коротко
- У генеративного сервиса два пути к ответу: запросить страницу в момент вопроса — тогда в журнале сервера остаётся запись — или собрать ответ без визита, не оставив следов. Проверку разводят по этим двум путям.
- Пустой журнал означает только отсутствие записи. И наоборот: страница среди источников ответа не доказывает, что краулер к ней приходил.
- Индексируемость и пригодность к цитированию — свойства разного рода. В одном разборе встретились страницы, где за исправным кодом сервера стояло несколько слов связного текста, а почти вся графика осталась без текстовых подписей.
- Отдельный пункт — делимость материала: подзаголовок называет предмет своего блока, блок заканчивается с исчерпанной мыслью, кусок понятен вне статьи. Наш порог самостоятельного фрагмента — рабочая эвристика, а не требование платформ.
- Выполненные пункты убирают препятствия, но попадания в ответ не обещают: логику отбора источников сервисы не раскрывают, а короткое окно наблюдения не доказывает, что робот не приходит вовсе.
Аудит сайта для LLM и AI Search отвечает сразу на два вопроса: доходит ли чужая автоматика до опубликованного материала, найдётся ли там выдержка для готового отклика. Пункты проверки расходятся по двум путям генеративного сервиса к пользовательскому тексту. Первый путь — запрос к площадке прямо по ходу вопроса, после него на стороне сайта остаётся запись. Второй обходится без визита: сервис способен ответить, ничего не запросив, — сервер остаётся чистым. Отсюда состав работы: часть пунктов осмысленна только при обращении, остальное проверяют по отклику. Дальше — устройство такой проверки, наблюдения технических разборов, рамка применимости выводов.
Два пути до ответа и зачем их разводят
| Путь | Что происходит | Что доступно наблюдению |
|---|---|---|
| Обращение в момент вопроса | автоматика запрашивает адреса, забирает содержимое, складывает отклик | журнал сервера: затребованный адрес, выданный код, подпись агента, глубина захода |
| Отклик без визита | ответ собирается без участия площадки | следов нет; читают выданный текст |
Разница здесь не терминологическая. Пункты, собранные под путь с визитом, на втором теряют почву: журнал молчит, а его тишина судьбу материала не описывает. Зеркальная ошибка не лучше: страница, всплывшая среди опор выданного текста, прихода сборщика не удостоверяет — путь её туда скрыт внешнему наблюдателю.
Аудит сайта для AI Search и проверка под LLM предъявляют содержанию одинаковые требования, доступу — свои. Срезы разобраны ниже, начиная с частой причины разочарования.
Узнайте, что нейросети говорят о нашем GEO-аудите
Ответ формирует сама нейросеть.
Проиндексировано — а брать нечего
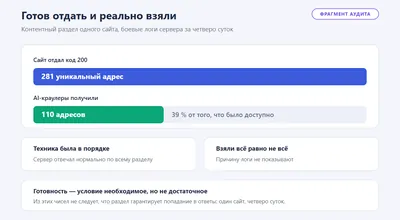
В техническом разборе локальной сервисной компании попались страницы, где вёрстка со скриптами весит изрядно, а связного текста набирается фраза-другая. Рядом нашлась вторая такая же: текста чуть больше, тоже абзац. Вес страницы здесь ничего не решает: объём занимают теги, стили и сценарии. Сервер отдаёт их успешным кодом, обычный поиск принимает, внешне порядок. В сводке рядового аудита такая страница выглядит исправной. Генеративному отклику взять нечего: выдержки нет. Разрыв возникает здесь: доступность поиску, пригодность готовому ответу — свойства разной силы, одно другого не влечёт.
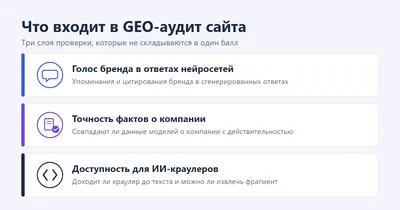
Там же почти вся графика обошлась без альтернативного описания. Для текстового извлечения содержания таких картинок не существует: режим работы, карта проезда снаружи неразличимы. Разрывы этого рода ищет GEO-аудит сайта: доступность площадки и пригодность её текста считаются раздельно, в общую оценку не сливаются.
Проверка с двух сторон
Со стороны сайта
Со стороны площадки проверяемы вещи приземлённые: состав визитёров, их подписи, полученные коды, однородность отдачи разным гостям. Куда добрался визит — до раздела с содержанием либо до служебных адресов. Доля обращений, ушедших в редирект или в несуществующий адрес вместо самого материала. Отдельная строка — совпадение выдачи: полученное автоматом сверяется с увиденным посетителем. Правила обхода, имена известных краулеров — тема отдельной публикации; здесь важнее присутствие записи либо её пустота.
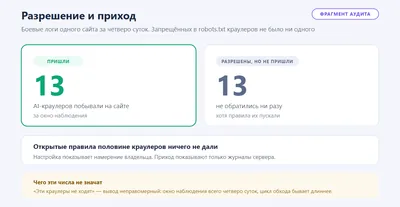
В одном разборе ответ сервера различался по имени клиента: часть обучающих агентов получала отказ там, где браузеру посетителя отдавался документ. Блокировкой это не называется — причина отказа из журнала не выводится, а агенты реального времени работали без помех.
Журналы проекта гостиничного девелопмента показали разброс: обучающий сборщик крупного вендора к сайту приходил, раздела с публикациями не коснулся; краулер системы с генеративной выдачей дошёл до содержания, прошёл по статьям. Записать можно ровно это. Вывод «материал в отклик не попал» неправомерен: дальнейшее применение скачанного текста запись не отражает.
Другой агент почти весь визит потратил на переадресацию: завершающий слэш в адресах отсутствовал. Последствия журнал снова скрывает; сосчитать удаётся единственное — долю обращений, израсходованных впустую.
Со стороны выданного ответа
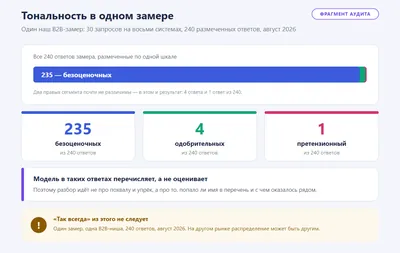
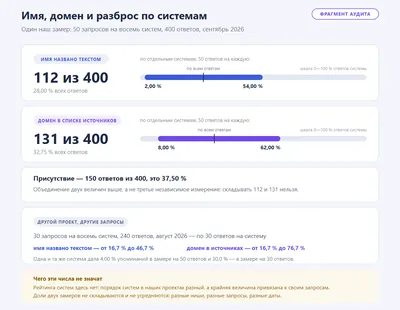
Визита не случилось — работает обратная сторона, выданный пользователю текст. Панель формулировок задают сервису, разбирают отклик: названо ли предприятие словами, попал ли домен в сноски, встречается ли опубликованное — услуга под своим названием, условие в своей формулировке.
В наших замерах поисковые переформулировки систем почти не содержали названий компаний: вопрос раскрывался по категории. Панель собирают из категорийных формулировок, имя предприятия ищут уже в отклике.
Результат прохода — срез, принадлежащий дате, панели вопросов, набору опрошенных сервисов. Чтобы следующему проходу было с чем сравниться, панель, список платформ, правила подсчёта фиксируют заранее и держат неизменными: иначе расхождение между прогонами неотличимо от смены методики.
Нарезаемость: кусок, который читается сам
В разобранных нами откликах публикация приходила фрагментом. Отсюда пункт проверки: разрезаемость материала по смыслу. Тот же разбор дал длинную статью с небольшим числом подзаголовков: каждый блок вышел настолько крупным, что самостоятельный отрывок вынести трудно — границы подтем внутри блока ничем не обозначены.
Порог осмысленного фрагмента у нас есть — рабочая эвристика, снятая с собственных разборов. Чужим требованием она не становится: внешней нормы такого рода мы не знаем, выдавать свою мерку за него нельзя. Назначение у неё скромное — подсказать разрез блока.
Состав пункта:
- подзаголовок называет предмет именно своего блока;
- блок кончается с исчерпанной мыслью;
- содержательные рисунки снабжены текстовой заменой;
- формулировка, критерий, перечень шагов вынесены самостоятельной строкой;
- термин раскрыт на месте, отсылка «как сказано выше» заменена условием;
- заголовки-вопросы оформлены разметкой: в разборе такие нашлись, разметка под ними
отсутствовала.
Проще отделяется готовая форма: таблица с подписанными столбцами, определение в одну фразу. Труднее — рассуждение, где каждая мысль висит на сказанном раньше. Пригодность куска проверяют простым способом: его читают вне статьи — понятен ли он в одиночку.
Чего такая проверка не обещает
Выполненные пункты снимают препятствия; попадания в отклик они не обещают. Отбор источников сервис не показывает, приписывать ему закономерность по итогам одной проверки метод запрещает.
Окно наблюдения — тоже ограничение. Короткий отрезок лога перечисляет пришедших за эти сутки; молчание робота внутри отрезка его отсутствия не доказывает — цикл обхода бывает длиннее окна. Наблюдения одного сайта на другие площадки не переносятся: сервер, темы, даты у них собственные.
Границу ставит и наш инструментарий. При сетевых сбоях прогона часть показателей в итог не попадает; честнее помечать их пропуском, чем зачислять в исправные. По части клиентов соединение не устанавливается вовсе — вывод тут невозможен ни в одну сторону. Автоматический обход тоже сдаёт неполную работу.
Спросите нейросеть о нашем GEO-аудите
Что из этого складывается
Проверка под генеративный поиск стоит на разведении обоих путей: обращение состоялось — читаются логи сервера, не состоялось — разбирается выданный текст. Совпадают оба пути в содержании: его достаточность, деление на куски, живущие вне своей страницы, словесный пересказ картинок. Разрыв между «проиндексировано» и «есть что забрать» закрывается с этой стороны, и распоряжается ею владелец ресурса.
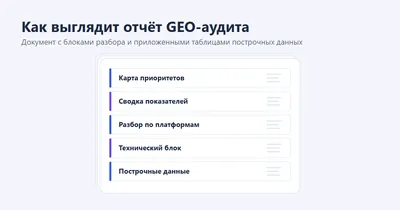
Собрать обе стороны в один отчёт и увидеть, что мешает забрать выдержку, — это GEO-аудит под нейросети. Начинать разумно со стороны, где записи есть.
Вопросы о проверке сайта под генеративный поиск
Сайт нормально индексируется в поиске. Этого хватит для генеративного ответа?
Не всегда. Индексируемость свидетельствует о приёме документа поисковой машиной. Пригодность к цитированию относится к содержанию страницы: при почти пустом тексте забирать нечего, успешный код сервера дела не меняет.
Что проверять для LLM, если в журналах ни одного обращения нет?
Остаётся сторона отклика: панель формулировок, запись встреченного в выданном тексте, дата, набор сред. Пустой журнал означает отсутствие записи, не более.
Нужно ли переписывать длинные материалы ради нарезки?
Целиком — редко. Работа идёт с границами блоков, подзаголовками: крупный раздел делится по смыслу, подзаголовок берёт собственный предмет. Место разреза подсказывает та же внутренняя мерка, обязательной нормой она не становится.
Обязательно ли альтернативное описание рисункам, когда текста на странице достаточно?
Да, когда рисунок несёт содержание: схема процесса, план расположения, график картинкой. Само изображение снаружи неразличимо. В том же проекте таких пояснений почти не было, часть смысла публикации осталась визуальной.
LLM-аудит сайта и проверка под AI Search — это две разные работы?
Частично. Общее — требования к содержанию: делимость, наличие текста, описанные картинки. Расходится доступ: один путь читается по журналам, другой записей не оставляет.
 AI-ready аудит сайта: проверка готовности к AI-поиску и нейросетям
 Что входит в GEO-аудит сайта и что он показывает
 Пример GEO-аудита сайта: как выглядит отчёт по AI-видимости
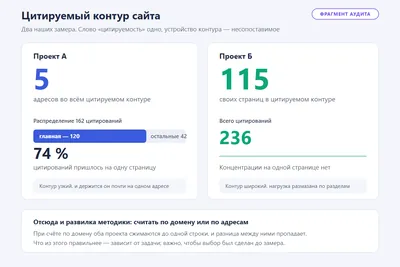 Цитируемость сайта в нейросетях: как измерять AI Citations
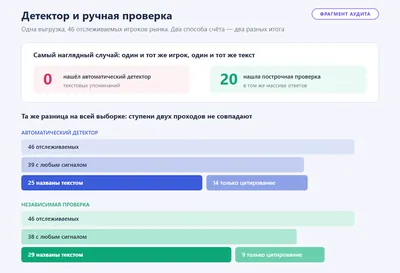 Упоминания бренда и сайта в нейросетях: как анализировать AI Mentions
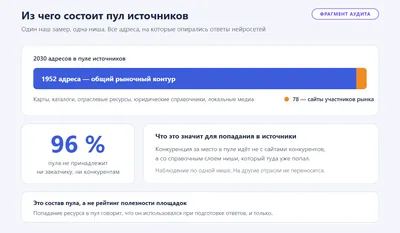 Источники нейросетей: какие сайты цитируют AI и как стать источником
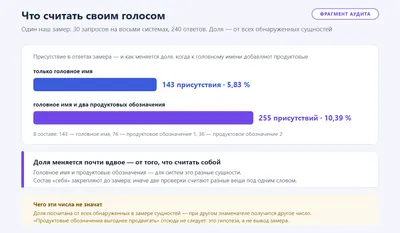 Share of Voice в нейросетях: как считать долю голоса бренда в AI
 Репутация бренда в нейросетях: контекст, сравнения и AI Benchmark
 Как провести GEO-аудит сайта и бренда: методика, этапы и чек-лист
 AI-краулеры и robots.txt: как проверить доступность сайта для нейросетей