AI-краулеры и robots.txt: как проверить доступность сайта для нейросетей
Какие AI-краулеры обходят сайт, что решает robots.txt, а что остаётся за его пределами, и как читать серверные логи, чтобы отличить разрешение от прихода.

Коротко
- Строка в robots.txt подтверждает только разрешение. Пришёл ли робот, видно по журналу сервера; что он прочитал — по списку затребованных адресов.
- Под «AI-краулером» скрываются три механизма с разными задачами: сборщик обучающего корпуса, наполнитель собственного индекса сервиса и агент, который открывает ссылку по ходу диалога. Их молчание в журнале читается по-разному.
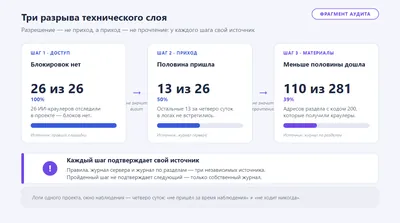
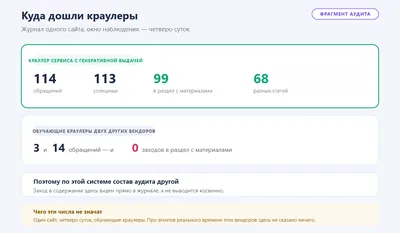
- За четверо суток наблюдения сайт посетили тринадцать AI-краулеров, и столько же разрешённых ботов не пришло ни одного раза. При этом один из обходчиков успел прочитать за этот срок десятки статей.
- Отклик сервера конкретному боту robots.txt не задаёт: его определяет конфигурация сервера или CDN, читающая подпись User-Agent сама. В журнале код ответа расходился по имени посетителя.
- Короткое окно наблюдения обманывает дважды: у части роботов цикл обхода длиннее среза, а сам файл правил кешируется и за несколько суток может не запрашиваться вовсе.
Открытая строка в файле правил подтверждает единственное — разрешение. Пришёл ли краулер, покажет журнал сервера. Прочитал ли он материал, покажет перечень затребованных адресов. Проверка robots.txt для нейросетей сличает три источника: текст предписаний, записи протокола и список путей, получивших отклик. Боевая выгрузка за четверо суток развела их в стороны. Ботам с полным разрешением не зачлось ни единого визита. Один обходчик за тот же срок прочитал десятки статей. Дальше — только слой доступа: разновидности гостей, полномочия директив, чтение записей, ловушка короткого среза.
Какие AI-краулеры обходят сайт и чем отличаются их задачи
Под словом «AI-краулер» прячутся три несхожих механизма. Смешение их в один комок ломает разбор.
| Тип обходчика | Публичные обозначения | Повод зайти | След в журнале |
|---|---|---|---|
| Сборщик обучающего корпуса | GPTBot, ClaudeBot, Google-Extended, CCBot, Bytespider | расписание вендора | ровная выборка страниц вне связи с чьей-либо репликой |
| Наполнитель своего индекса | PerplexityBot | пополнение базы под будущие ответы | широкий разброс путей, манера поискового робота |
| Агент прямого отклика | ChatGPT-User, Perplexity-User | диалог: сервис раскрывает ссылку | один-два пути, привязанных к свежей реплике |
Сборщик корпуса трудится по расписанию вендора, безотносительно чатовой реплики. Его сегодняшний визит ещё не предвещает, что текст войдёт в ближайшее обновление модели: сроки переобучения вендоры держат при себе.
Наполнитель индекса подходит ближе к поисковой машине, только база своя, закрытая, размер её снаружи неизвестен. Оттуда сервис черпает материал готовой выдачи человеку.
Третий тип приходит в момент диалога — система раскрывает ссылку сама либо по просьбе собеседника. Такая вылазка привязана к разовому запросу, выглядит она в записях иначе, чем размеренная поступь корпусного робота.
Размежевание важно для диагностики: одинаковое молчание журнала у первого типа и у третьего толкуется по-разному. Та же несхожесть вылезает внутри одного замера: обучающие сборщики двух крупнейших систем ограничились считаными обращениями и до контентной рубрики не добрались, пока второй тип за те же сутки прочитал десятки статей. Повадки конкретных платформ, включая ChatGPT, разобраны в другом материале цикла; здесь важен сам принцип деления по задачам.
Что решает robots.txt, а что остаётся за его пределами
Полномочие у документа одно: он распределяет разделы домена между именованными краулерами — кому открыто, кому закрыто. Дальше его власть кончается.
Приход допущенного бота остаётся его решением. Расписание и приоритеты сканирования принадлежат ему; запись в файле снимает запрет и этим исчерпывается, приглашением она не служит. Отсюда разрыв в замере: часть проверенных и явно открытых AI-агентов за наше окно в журнале не встретилась. Дверь открыли, гость не пришёл. Вывод «сюда не ходят» преждевременен: у ряда сервисов круг обхода тянется дольше, чем длился наш срез.
Распоряжаться полученным доступом директива тоже не может. Допуск в раздел и интерес к его содержимому — величины независимые: корпусный робот способен сделать считаные обращения и уйти, даже когда домен открыт ему целиком.
Отклик сервера именно этому гостю складывается в стороне от директив. Их забота — допуск; код состояния и содержимое страницы задаёт конфигурация хоста или CDN — та читает подпись User-Agent самостоятельно. В протоколе статус расходился по имени посетителя: часть обходчиков вместо обычного ответа получала нестандартный код. Свод предписаний этим не управляет и об этом молчит.
За свежесть записи в памяти ботов документ тоже не поручится. Сам он кешируется; за недолгий период может вообще не запрашиваться — так вышло у нас: за четверо суток его никто не затребовал. Значит, по короткой выгрузке не установить, подтянул ли конкретный агент обновлённую версию.
Отдельное наблюдение о структуре свода: персональной группы директив под AI-ботов в проверенном файле не нашлось — они шли под общим правилом со всеми ограничениями, поисковые системы пользовались личными исключениями. Попасть под общее правило просто: имя в директиве и подпись в журнале должны сойтись, иначе личный блок не сработает. Сами AI-агенты заданные им нормы соблюдали: нарушений по контентному разделу протокол не зафиксировал.
Устройство технического слоя площадки под нейросети целиком разобрано в отдельном материале о составе технического GEO-аудита — здесь речь только про слой доступа. Если непонятно, с чего начинать проверку конкретного домена, GEO-аудит сайта закрывает этот вопрос быстрее, чем разбор настроек вручную.
Как читать серверные логи и почему короткий срез обманывает
Настройки смотрят однажды, журнал живёт и пополняется. Берут его у хостера либо снимают в панели CDN. Строка журнала несёт дату, время, метод обращения, запрошенный путь, код состояния и подпись User-Agent. Смотреть стоит на три вещи зараз.
Первое — обозначение краулера. Публичные обозначения вендоры печатают в документации, по ним выгрузка фильтруется на искомого посетителя, минуя сваленный в кучу AI-трафик.
Второе — статус отклика и адрес назначения. Обращение к хосту даёт половину сведений; вторая половина — куда оно пришло: на главную, в служебную зону, в раздел со статьями. Визит мимо контентных страниц толкуется так: машина выбрала иной маршрут в этот заход.
Третье — повторяемость по датам внутри периода. Единичный заход не тянет на систему. Обратное тоже верно: сутки наблюдения способны случайно обронить деятельного бота с многонедельным ритмом сканирования. Чем длиннее ряд, тем спокойнее вывод: соседние сутки сглаживают случайный провал.
Сборка фильтра выглядит буднично: выбрать строки с нужным именем, сгруппировать по датам, разложить маршруты по глубине вложенности. Остальное — арифметика: сложить заходы по дням, посмотреть, где ряд рвётся. Дальше видно, упёрся ли посетитель в корень домена или спускался к статьям.
Небольшое окно подводит дважды. Периодичность у каждого своя: пустая графа за несколько суток ещё ничего не отменяет. Плюс кеш — свод лежит в памяти сканера, и если тот перечитывает его редко, свежесть по недолгому срезу не устанавливается. Разовый снимок годится для первой диагностики; вывод о регулярной повадке требует длинного ряда замеров или череды снимков подряд. Смежный вопрос — готовность площадки к обходу в целом, им занимается соседний материал цикла; служебный файл llms.txt разбирается отдельно и здесь не раскрывается.
Типичные ошибки при настройке доступа для AI-ботов
- «Разрешили — значит придут». Открытая строка снимает запрет, решение о визите принадлежит краулеру и его расписанию. Факт сканирования подтверждает выборка за весь период; настройки бессильны.
- «Не пришёл — значит не ходит». Небольшой отрезок наблюдения ловит лишь те машины, чей круг укладывается в этот срок. Молчание выгрузки за несколько суток умалчивает о повадке на более долгом интервале. Лечится продлением отрезка; директивы тут трогать незачем.
- «Нет запретов — значит всё в порядке». Отсутствие блокировок умалчивает о двух вещах сразу: читается ли текст или пропускается, и отвечает ли хост всем посетителям одинаковым статусом и содержимым. Оба сомнения закрывает сверка статусов и затребованных ссылок по датам.
Спросите нейросеть о нашем GEO-аудите
Вывод
Разрешение, приход и прочтение — три разных события, и каждое подтверждается своим источником: текстом предписаний, журналом сервера, разбором того, какие адреса получили ответ. robots.txt закрывает первое из трёх и молчит про остальные два. Если нужно понять, что из этого происходит на конкретном домене, аудит видимости сайта в нейросетях строится на разборе логов, а не на пересказе настроек.
Вопросы и ответы
Нужна ли отдельная группа правил в robots.txt под каждого AI-краулера или достаточно общей?
Персональная группа даёт точечный контроль: корпусного робота разрешают, второго ограничивают, нормы поисковых систем остаются нетронутыми. Общая группа на всех — случай из наших логов: AI-боты попадали под сплошные запреты, поисковики пользовались личными исключениями.
Как в логах отличить сборщика обучающего корпуса от агента, зашедшего по ссылке в диалоге?
По повадке за период. Корпусный обходчик идёт узнаваемым паттерном безотносительно единичного маршрута, а диалоговый гость обычно привязан к паре ссылок, которые кто-то затребовал только что. Разницу выдаёт разброс запрашиваемых маршрутов; одна вылазка её не покажет.
Если нужная машина не зашла за время наблюдения, стоит ли сразу менять директивы?
Не обязательно. Предписания уже могли разрешать визит — тогда менять нечего, а молчание объясняется более длинным кругом сканирования или решением самой платформы. Прежде чем трогать документ, логично продлить окно замера.
Проверяет ли свод директив, что сервер одинаково отвечает разным AI-ботам?
Нет. Документ регулирует допуск к обходу. Отдаваемый код и содержимое страницы — самостоятельная настройка хоста или CDN, которая читает подпись клиента независимо от правил.
 llms.txt для GEO: что проверять и как использовать на сайте
 Schema.org и JSON-LD для GEO: микроразметка сайта под нейросети
 Индексация сайта в нейросетях и AI-поиске: что реально можно проверить
 Технический GEO-аудит сайта: что проверить перед продвижением в нейросетях
 Мониторинг AI Visibility: как отслеживать видимость бренда в нейросетях
 Что делать после GEO-аудита: план роста AI-видимости
 GEO-аудит сайта для Gemini: анализ видимости бренда и источников
 GEO-аудит сайта для Perplexity: видимость, источники и цитируемость
 GEO-аудит сайта для Алисы и Яндекс AI-поиска
 GEO-аудит сайта для Google AI Overviews: видимость, цитирование и источники