GEO-аудит сайта для Gemini: анализ видимости бренда и источников
Чем аудит под эту систему отличается от общего: веер подзапросов читается построчно, и это добавляет к проверке то, чего у большинства соседних платформ не видно.

Коротко
- Gemini отдаёт наружу третий пласт данных, которого у большинства систем нет: формулировки вспомогательных поисковых запросов текстом, построчно. К подсчёту упоминаний и цитирований добавляется чтение самого маршрута.
- Читают эти строки парами с исходным вопросом пользователя: вне привязки одна и та же формулировка означает разное.
- В наших замерах имя компании внутри таких строк звучало нечасто — чаще проступали товарная категория и свойства услуги. Соотношение мы фиксируем, а объяснять его не берёмся.
- Перечень показывает, какие формулировки попали в выдачу, но не объясняет, почему отобраны именно они, и не говорит, повторится ли раскладка при том же вопросе.
- Упоминание бренда в вспомогательном запросе и его появление в итоговом ответе — разные слои. Широкий веер не гарантирует попадания в ответ, узкий его не запрещает.
GEO-аудит для Gemini разбирает три пласта данных — соседние системы отдают два. Третий пласт, поисковые фразы: платформа складывает их рядом с готовым ответом и отдаёт текстом, построчно. Большинство измеряемых сервисов выпускает наружу лишь исход: назвала модель компанию или промолчала, процитировала домен либо прошла мимо. К исходу добавлен маршрут — перечень промежуточных обращений, ушедших искать перед сборкой итогового абзаца. Видимость сайта в Gemini поэтому измеряют с добавочным заходом: кроме упоминаний и цитирований аудитор читает сам реестр строк. Важно, что стоит в центре — имя фирмы или товарная категория, — и насколько широко развёрнута исходная просьба человека. Ниже разобрано, чем пополняется такая проверка, какие выводы она выдерживает, где прочитанное легко истолковать превратно.
Что аудит Gemini показывает такого, чего нет у большинства соседей
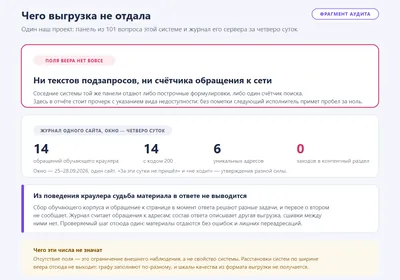
Два привычных пласта везде считают одинаково: фиксируют, прозвучало ли название и попал ли домен в список опорных. Среди систем нашего замера эта выделяется наполнением третьего, технического поля. Часть сервисов такой секции лишена вовсе: наружу уходит готовый ответ, а поисковая подготовка остаётся за кадром — пример ChatGPT, ему посвящён отдельный материал серии. У других блок есть, но лежит в нём лишь счётчик: отметка о состоявшемся визите к поисковику, без единой строчки содержания. Нас занимает третий вариант: внутрь уложены сами формулировки — развёрнутые, предметные, стилистически ближе к поисковому окну, чем к живой речи спрашивающего. Различие между тремя вариантами не стилистическое: от него зависит, что по площадке измеримо.
В одном нашем замере такой перечень оказался у модели шире, чем у прочих измеренных систем того же прогона. Отсюда смещение состава работы: анализ AI-видимости не сводится к подсчёту названных имён, к нему прибавляется построчное чтение маршрута. Читать приходится дольше, однако крепнет доказательная база.
Как устроен веер подзапросов у этой системы
Поле лежит в технических метаданных, вплотную к прочему наполнению выдачи — ссылкам, выдержкам, служебным отметкам. Содержимое — полноценные текстовые строчки, а не номера и не коды. Каждую удаётся разобрать по словам, словно обычную поисковую фразу, и каждая годится к машинной обработке без расшифровки. Привязка у реестра своя: он вырастает из заданного вопроса, поэтому читают парами — просьба человека и выросшая из неё развёртка. Без привязки получается случайный ворох: одно выражение значит разное, смотря из какого вопроса выросло.
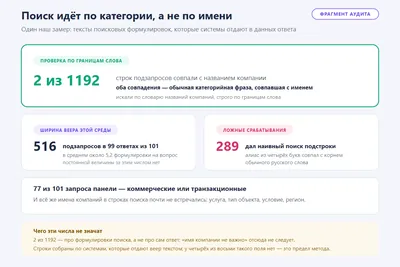
В содержании заметна повторяющаяся закономерность: имя компании звучит в строках нечасто, отчётливее проступают категория и свойства товара или услуги. Такое соотношение в наших замерах встретилось почти повсеместно, где след поисковой подготовки читается построчно, — особенность не единичная. Пропорцию мы фиксируем, объяснять её не берёмся.
Тут проходит граница метода чтения. Реестр раскрывает набор фраз, попавших в итоговую реплику, а причину отбора не объясняет: почему взяли эти варианты, отбросили прочие, по нему не определить. Повторится ли раскладка при следующем обращении с прежней постановкой вопроса, тоже неизвестно — повторных прогонов одного запроса в нашей практике нет. Перед нами срез единичного состояния на момент съёма, а устройство подбора внутри закрытого сервиса скрыто. Соблазн достроить механику велик, и поддаваться ему нельзя: наблюдаемы наполнение поля и его размер, порядок отбора — нет. Ровно здесь платформенные разборы съезжают в беллетристику.
Какие проверки добавляет аудит сайта под Gemini
Читаемый след подготовки открывает сверки, невозможные при единственном итоге. Каждая отвечает отдельному вопросу владельца.
- Чтение каждой строки: в центре у неё марка либо родовое понятие. Этот слой считают отдельно от названного в готовом ответе.
- Поиск соперников по вееру — независимо от финального текста: конкурент способен попасть в промежуточный запрос, минуя видимую пользователю реплику; бывает обратный случай.
- Сверка объёма перечня с результатом упоминания и цитирования по одному вопросу: широкая раскладка не гарантирует фирме появления в ответе, узкая её не запрещает.
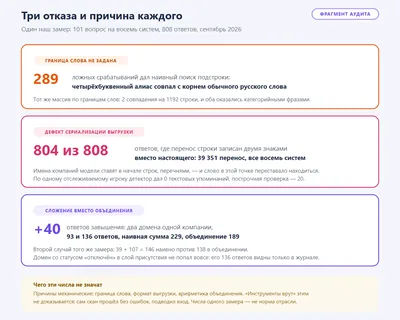
- Контроль совпадений по границе слова: наивный перебор подстроки ловит нарицательный корень, такое пересечение без ручной вычитки в отчёт не попадает.
| Срез проверки | Что показывает | Что не показывает |
|---|---|---|
| Текст подзапросов | состав формулировок, вошедших в выдачу | причину, по которой отобраны именно они |
| Присутствие бренда в подзапросах | названа ли компания внутри поисковой фразы | названа ли она в итоговой реплике — это отдельный слой |
| Присутствие конкурентов в подзапросах | попал ли соперник в промежуточный запрос | попадёт ли он в финальный текст |
| Ширина веера | насколько подробно разложен вопрос пользователя | качество или полноту итоговой реплики |
Перечисленные разрезы работают вместе со стандартным учётом упоминаний и цитирований: полная картина складывается из обоих пластов сразу. Обещаний попасть в ответ никто не даёт — описано наблюдаемое положение дел на момент съёма, дальнейшая судьба запроса — вне измерения.
Типичные ошибки при чтении веера Gemini
При разборе массива регулярно встречаются одни и те же промахи.
- Считать пропажу фирменного имени в строках поводом для тревоги: по нашим замерам картина рядовая — родовые понятия и свойства товара перевешивают бренд.
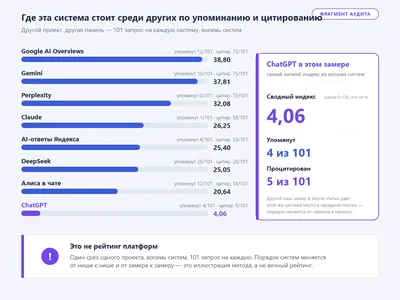
- Сравнивать объём перечня между платформами ради рейтинга: секцию заполняют по-разному, а ширина — свойство отдельного замера, универсальную шкалу качества отсюда не вывести. Формат выгрузки у вендоров разный изначально.
- Искать алиас простым перебором подстрок, минуя границу слова: сокращение совпадает с обычным корнем, и отчёт получает ложные срабатывания.
- Ожидать повторения набора при прежнем вопросе: устойчивость следа во времени не проверена.
- Путать упоминание марки в развёртке с появлением в реплике: это разные пласты, общий вывод по ним ошибочен.
Спросите нейросеть о нашем GEO-аудите
Итог: что это меняет для аудита
Материала для разбора тут больше, чем дают соседи по замеру: дорога к ответу написана словами. Прогноз на будущее надёжнее не становится: повторяемость следа мы не проверяли, а мгновенный слепок предсказанием не служит. Зато появляется точечная работа: прочитать фразу, поискать себя рядом с конкурентом ещё до готового ответа, сверить ширину с итогом. Остальное про механику подбора закрытый сервис оставляет при себе, достраивать её домыслами незачем. Для заказчика разница практическая: спорное место открывается и перечитывается.
Чтобы увидеть маршрут по собственному сайту и своей панели запросов, стоит заказать GEO-аудит с разбором именно этого слоя, а не одного итогового счёта.
Частые вопросы об аудите видимости в Gemini
Если название компании не встречается среди самих поисковых фраз, значит ли это, что разбор ничего не нашёл?
Нет. Подзапросы — обособленный пласт данных, пропажа марки здесь обычное дело: товарная категория или услуга звучит чаще имени. Упоминания бренда в Gemini и цитирование доменов проверяются порознь и могут оставаться рабочими даже при пустом по марке веере. Заключение по единственному слою половинчато: сверять стоит оба среза подряд.
Можно ли сравнивать эту платформу с другими по ширине веера?
Сопоставление допустимо в пределах прогона, и то осторожно: у иных площадок секция пуста, у некоторых хранит счёт. Объём развёртки говорит о дроблении темы в наблюдаемой выдаче, оценкой модели целиком он не становится. Полезнее следить за одной площадкой по неизменному набору вопросов.
Веер виден по каждому ответу без исключения?
В нашем окне наблюдения строки нашлись в подавляющем большинстве случаев, хотя не повсюду: часть выдач обошлась без развёрнутой раскладки. Причины отдельных пропусков массив не выдаёт — перед нами снимок, объяснений механики тут нет. Пропуск тревожным знаком не считается.
Чем веер подзапросов отличается от списка процитированных источников?
Это разные объекты одной выдачи. Первый — формулировки, отправленные поисковику до сборки реплики. Второй — домены, попавшие в слой источников. Смешение тут опаснее остальных промахов: заготовка выдаётся за достигнутое.
Нужно ли фиксировать состав веера при повторных замерах?
Да, если задача — сопоставлять результаты во времени. Ради честного сравнения панель запросов, список площадок и правила подсчёта закрепляют одинаковыми заранее: иначе разница раскладок покажет смену выборки, видимость останется неизвестной. Правка панели обнуляет сопоставимость целиком.
 GEO-аудит сайта для Perplexity: видимость, источники и цитируемость
 GEO-аудит сайта для Алисы и Яндекс AI-поиска
 GEO-аудит сайта для Google AI Overviews: видимость, цитирование и источники
 GEO-аудит сайта для DeepSeek: анализ видимости и упоминаний
 GEO-аудит сайта для Claude: анализ видимости и цитирования
 GEO-аудит сайта для Google AI Mode: видимость бренда, источники и AI-выдача
 GEO-аудит сайта для ChatGPT: видимость, упоминания, цитирование и конкуренты
 Как попасть в ответы и рекомендации нейросетей: что можно улучшать
 Аудит сайта с помощью ИИ: что нейросеть может проверить, а что нет
 Что входит в GEO-аудит сайта и что он показывает