llms.txt для GEO: что проверять и как использовать на сайте
Какой статус у llms.txt сегодня, что показал наш замер спроса на него и чего из этого замера не следует, а также что проверять, если файл уже заведён.

Коротко
- llms.txt — добровольная текстовая опись в корне сайта: короткое описание проекта и перечень материалов для языковых моделей. Обязательным стандартом формат не стал, обязательств читать его ведущие разработчики не давали.
- Три служебных файла заняты разным: robots.txt распределяет доступ, sitemap.xml перечисляет адреса для индексации, llms.txt пытается дать смысловые ориентиры. Строка в описи доступом не распоряжается.
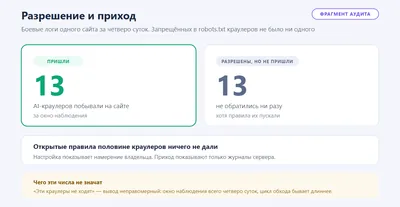
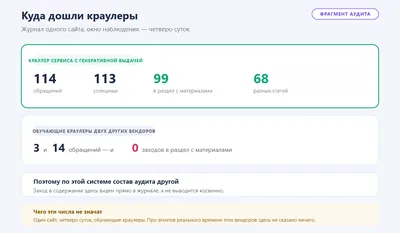
- В одном нашем аудите за четверо суток sitemap.xml запрашивали 27 раз. На llms.txt пришло пять обращений и два на ai.txt, все они получили код 404. Крупные AI-краулеры этот адрес не запрашивали.
- Вывода «файл не нужен» из этого не выходит, как и обратного: окно наблюдения короткое, журнал один, а пропуск несуществующего файла ничего не говорит о поведении бота при корректно оформленном.
- Если опись уже есть, её сверяют по четырём пунктам: отдаётся ли сервером, живые ли ссылки, совпадают ли пометки с содержимым страниц, читается ли формат простым текстом. Неисправная опись хуже отсутствующей.
llms.txt — текстовый файл в корне сайта: короткая характеристика проекта плюс перечень материалов, адресованных языковым моделям. В каждой строке — адрес документа, пометка о содержимом, иногда отсылка к расширенной версии. Формат предложили добровольной надстройкой над тем, что ресурс уже отдаёт через HTML, robots.txt и sitemap.xml, без претензии их заменить. Статус сегодня именно такой: необязательная опись без закреплённого порядка проверки. Публичных обязательств читать её и менять по ней обход или ответ ведущие разработчики пока не давали. Решение про llms.txt для GEO откладывать незачем, вопрос другой: какие ожидания обоснованны. Дальше — собственный замер по логам: кто из реальных AI-краулеров сюда заходил и каков итог.
Что кладут в llms.txt и чем он отличается от robots.txt и sitemap.xml
Внутрь обычно пишут краткое описание проекта, дальше — список разделов с пояснением, о чём каждый: документация, блог, справочник API, условия использования. Форму подсказывают черновики спецификации: заголовки плюс ссылки. Рядом описан расширенный вариант — большая выгрузка, куда складывают статьи целиком. Обязательных полей схема не задаёт, поэтому реализации у площадок заметно расходятся глубиной: где-то десяток строк, где-то развёрнутая карта всего справочника. Расположение жёсткое: корень домена, латиница, нижний регистр. О вложенных копиях внутри рубрик спецификация умалчивает.
Три служебных документа решают разные задачи:
- robots.txt — директива доступа: что роботу открыто, что закрыто. Правило обхода; описание смысла остаётся соседям.
- sitemap.xml — список URL под индексацию, формальный, без интерпретации смысла публикации.
- llms.txt — попытка дать смысловую выжимку и ориентир по главным публикациям системам, которые текст читают и обобщают, помимо сухой каталогизации.
Разница практическая. Первый управляет визитом бота. Второй облегчает обнаружение URL. Третий теоретически помогает отобрать значимые фрагменты. Подтверждения такому применению от ведущих агентов отсутствуют.
Формальных полей спецификация не вводит вовсе. У второго найдётся отметка последнего изменения, частота обновления, приоритет; тут сплошная выжимка — даты, веса, ранги она не хранит. Следить за свежестью приходится вручную, внутренним расписанием.
Отсюда практическое следствие: упоминание в описи правами доступа не управляет. Их задаёт robots.txt, там же решаются запреты.
Что показал наш замер — и чего из него не следует
Фактура дальше — из одного нашего аудита (аудит видимости сайта в нейросетях, B2B-компания гостиничного девелопмента, окно наблюдения — несколько суток). Путь /llms.txt запрашивали считаные разы; каждое обращение получило код несуществующей страницы: на сервере пусто. Соседний /ai.txt повторил картину. Среди ведущих AI-краулеров, чьи визиты мы различали в журнале по отдельности, этот адрес в запросах отсутствует вовсе. Для контраста /sitemap.xml за тот же период вызывали регулярно — заметно чаще и стабильнее.
Вывод «ресурсу такая запись незачем» отсюда неправомерен. Короткое окно плюс единственный журнал — узкая база. Судить обо всём рынке и будущем поведении сборщиков рискованно: разработчики моделей меняют список обслуживаемых агентов без публичного расписания, предсказывать следующий срез мы не берёмся. Обратный вывод — «заводить обязательно, раз так советуют гайды» — опирается на ту же пустоту. Подтверждено ровно одно: в нашем окне наблюдения крупные краулеры адрес llms.txt не запрашивали, а обращения к sitemap.xml в это же время шли стабильно. Исход замера, а не свойство протокола и не прогноз. Повторного среза здесь пока не делали — сравнивать нечего.
Оговорка: пропуск несуществующего файла умалчивает о том, как бот повёл бы себя при корректно оформленном. Факты разные, смешивать их нельзя.
Что проверять, если файл уже заведён
Готовая запись требует периодической сверки по четырём направлениям. Неисправная хуже отсутствующей: создаёт видимость аккуратности там, где её нет.
| Что проверять | Как это сделать | Что это показывает |
|---|---|---|
| Доступность | Открыть прямой URL в браузере или запросить через curl, посмотреть код отклика | Документ отдаётся сервером, а не живёт только в документации |
| Актуальность перечня | Сверить строки с нынешней картой разделов | Ссылки ведут на живые адреса, а не удалённые или переехавшие |
| Соответствие содержимому | Открыть публикации из перечня и сравнить пометки с реальным наполнением | Краткое пояснение не обещает того, чего в тексте нет |
| Формат | Убедиться: структура читается простым текстом без скрытой разметки | Парсер не спотыкается на лишних символах |
Тревожных исходов немного: пустое тело, редирект на главную, битая ссылка. Полезна и обратная сверка: пройти навигацию сверху донизу, отметить пропущенное. Пропуск опаснее дубля. Проверку удобно повесить на сборку: расхождение всплывает сразу, ручной ритуал излишен.
К формату относятся кодировка, расширение: UTF-8, без лишних символов в начале. Полезно заранее назвать ответственного за правку: реестр живёт в репозитории, а наполняют его редакторы — зона другая.
Ещё один пункт — обновление вслед за перестройкой проекта: добавили раздел, сняли старый, переименовали домен документации. Без этого шага перечень устаревает. Процедуру чтения логов и поведение роботов разбирает материал про AI-краулеры и robots.txt; здесь речь только о самом реестре.
Более широкий технический разбор — состояние HTML, скорость отклика, alt-тексты, каноникал — собран в материале технический GEO-аудит сайта, где llms.txt занимает один пункт.
Кому llms.txt может быть полезен независимо от краулеров
Польза описи шире внимания ботов.
Во-первых, внутренняя карта значимых материалов команде. Перечень с пояснениями задаёт порядок, который пригождается при разборе заметности домена в ответах нейросетей и планировании контента — безотносительно визитов агентов. Заодно короче вводная беседа с новым подрядчиком: открыл корень, прочитал, спросил по существу.
Во-вторых, команда письменно называет свою опору. Формулировка переводит спор о приоритетах из переписки в правку.
В-третьих, оглавление встраивается в более широкую логику присутствия домена в источниках AI-ответов: механику цитирования распутывает соседняя статья — источники нейросетей и как ими становятся. Наличие сводки источником ресурс не делает, но держит картину в порядке.
Наконец, правила со временем меняются: вендоры публикуют рекомендации, запускают новых сборщиков. Готовый выверенный реестр — низкая цена за спокойствие на случай перемен. Поддерживать на ходу дешевле, чем пересобирать с нуля.
Спросите нейросеть о нашем GEO-аудите
Вывод
llms.txt — лёгкая в поддержке служебная сводка, и на сегодня это открытый вопрос, а не отраслевая обязанность. Собственный замер показал единичные обращения вхолостую и ни одного запроса от крупных AI-краулеров, тогда как sitemap.xml в тех же логах вызывали стабильно. Ни отказ, ни спешное внедрение отсюда не вытекает — скорее повод сверяться с собственными логами прежде, чем следовать общим советам. Если нужен независимый взгляд на то, что на площадке уже готово под чтение нейросетями и чего там технически недостаёт, этим занимается GEO-аудит сайта — служебная обвязка, строение контента и доступность под обход разбираются единым отчётом, без догадок поверх чужих рекомендаций.
Вопросы про llms.txt
Нужно ли удалять запись, если краулеры её не запрашивают?
Короткое наблюдение такого основания не даёт. Нагрузки она не создаёт, с соседями по корню мирно сосуществует. Хранение бесплатно, вопрос в другом: тратит ли команда внимание без ясной цели.
Может ли llms.txt заменить правильную разметку страницы?
Нет, это два этажа работы. Разметка — заголовки, вложенность, микроразметка — влияет на разбор конкретной страницы. Сводка работает верхнеуровнево. Один другого не подменяет.
Как часто обновлять llms.txt?
Единого стандарта частоты нет. Разумный ориентир — каждая перестройка структуры: новая крупная рубрика, переезд справочника, чистка устаревшего. Привязка к релизу надёжнее календаря: правка едет вместе с изменением.
Нужны ли отдельные версии под ChatGPT, Gemini, Perplexity?
Единого стандарта, закреплённого всеми вендорами, сегодня нет, поэтому отдельные «версии под платформу» делать незачем. Разница поведения сборщиков касается скорее доступа.
Можно ли проверить, что модель прочитала именно llms.txt при формировании ответа?
Прямого способа подтвердить это со стороны владельца нет. Журнал сервера покажет сам заход и код отклика, но не то, как содержимое использовалось при генерации конкретной реплики.
 Schema.org и JSON-LD для GEO: микроразметка сайта под нейросети
 Индексация сайта в нейросетях и AI-поиске: что реально можно проверить
 Технический GEO-аудит сайта: что проверить перед продвижением в нейросетях
 AI-краулеры и robots.txt: как проверить доступность сайта для нейросетей
 Мониторинг AI Visibility: как отслеживать видимость бренда в нейросетях
 Что делать после GEO-аудита: план роста AI-видимости
 GEO-аудит сайта для Gemini: анализ видимости бренда и источников
 GEO-аудит сайта для Perplexity: видимость, источники и цитируемость
 GEO-аудит сайта для Алисы и Яндекс AI-поиска
 GEO-аудит сайта для Google AI Overviews: видимость, цитирование и источники