GEO-аудит сайта для Perplexity: видимость, источники и цитируемость
По этой системе об одном обращении остаются две независимые записи — журнал сервера и перечень взятых страниц. Что это добавляет к проверке, где записи смыкаются и чего по ним судить нельзя.

Коротко
- По Perplexity обращение к сайту оставляет два независимых следа: журнал сервера с именем агента, временем и кодом отклика и перечень найденных страниц, который система показывает рядом с ответом.
- В одном окне наблюдения краулер сервиса сделал 114 обращений, 113 из них успешных, дошёл до 68 разных статей. Обучающие сборщики двух других вендоров в раздел с материалами не заходили вовсе.
- Это наблюдение по одному проекту за четверо суток: свойством сервисов и отраслевой нормой оно не становится.
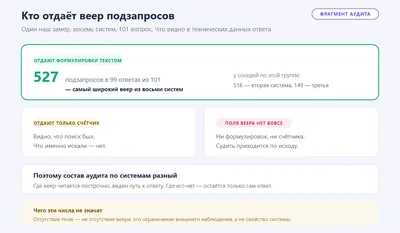
- В техническом поле выдачи Perplexity лежат адреса найденных документов, а не формулировки поиска. Итоговый состав источников открыт целиком, а путь к нему — нет.
- Сведение двух записей сужает спор до конкретной страницы и даты: по каждому материалу видно, приходил ли к нему робот и попал ли адрес в источники. Причину выбора журналы не объясняют.
Обращение этой платформы к сайту фиксируют две независимые записи, и GEO-аудит для Perplexity сводит их воедино. Первую пишет сервер: журнал доступа называет пришедшего агента, время, забранный адрес, код отклика. Вторую выкладывает сама выдача — рядом с готовым ответом система перечисляет найденные страницы, тогда как соседние сервисы заполняют то же техническое поле своими поисковыми обращениями. Измеримым оказывается материальный состав ответа; дорога к нему наружу закрыта. Ниже разобрано: что видно с обеих сторон, где они совпадают, чего по этой платформе узнать нельзя.
Два свидетельства об одном обращении
Большинство измеряемых систем оставляет аудитору один слой — готовую реплику. Выгрузка сообщает итог: прозвучало ли название текстом, стоит ли домен в сносках. Добрался ли робот до самих публикаций, оттуда не прочитать — дальше начинается домысел.
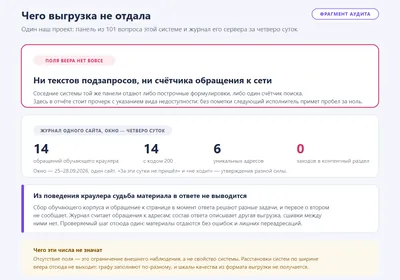
Тут к итогу прибавляется фактический след обхода. Серверные строки проекта показали: краулер этого сервиса выбрал раздел со статьями, прошёл по множеству отдельных материалов — лучшее покрытие среди AI-краулеров того окна наблюдения. Оговорка обязательна: короткий отрезок, единичный проект, отраслевой нормы отсюда не вывести. Сборщики обучающего корпуса двух крупнейших вендоров тогда же до статей не добрались — этим наблюдение исчерпано; про агентов реального времени логи молчат.
О причине расхождения они умалчивают: событие регистрируют, толкование оставляют за кадром. Достраивать его догадкой нельзя — иначе проверка сайта под ИИ превращается в рассказ о неизмеренном.
Узнайте, что нейросети говорят о нашем GEO-аудите
Ответ формирует сама нейросеть.
Сторона сервера: что попадает в журнальную строку
Бот минует счётчик посещений и кабинет поисковика: те считают людей. Визит робота оседает построчно в журнале доступа. Имя агента там — строка, которую клиент сообщает сам; её сверяют, прежде чем засчитать приход платформе.
Разбирают запись по четырём вопросам:
- приходил ли такой агент вообще, насколько часто;
- какие разделы получил — статичные страницы, служебные файлы, публикации с развёрнутым ответом;
- широко ли покрыта содержательная часть: отдельный материал или заметная доля;
- чем отвечал сервер — обычным документом, редиректом, ошибкой.
Почти все обращения краулера завершились успешным кодом; внутри ресурса он выбирал статьи. Отсюда следует доступность материала тех суток. Разрешающее правило robots.txt приход лишь допускает. Состоявшийся заход — тоже половина дела: полноту отданного документа подтверждают порознь. Глубина хранения ограничена ротацией: давние записи затираются, сверку назначают по уцелевшему отрезку. Прочие боты и нормы для них разобраны в материале про AI-краулеры и правила обхода.
Сторона выдачи: перечень страниц вместо развёртки вопроса
Иные платформы заполняют техническое поле выдачи самими формулировками поиска — тогда подготовка ответа видна снаружи. Perplexity кладёт туда другое наполнение: адреса найденных документов. Как она искала, со стороны не прочесть, зато итоговый набор источников открыт целиком, сопоставим с сайтом напрямую.
Список делится на собственные адреса и чужие; последние — на публикации прямых соперников и общий рыночный контур: каталоги, отраслевые медиа, справочники. Цитирование в Perplexity по такому списку и считают: домен попал в опоры заданной формулировки либо отсутствует. Методику подсчёта описывает разбор цитируемости сайта в нейросетях, тут она применена к единственному сервису.
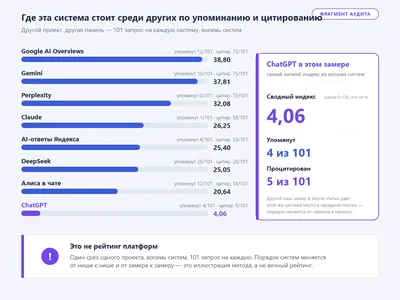
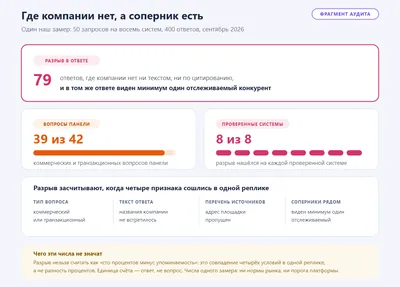
Второе наблюдение этой стороны — рассогласование слоёв у самой платформы. В нашем замере её ответы опирались на домен часто, а названия компании в текстах не прозвучало ни разу. Иная панель другой ниши — там имя всплывало заметно чаще. Поэтому видимость сайта в Perplexity измеряют двумя слоями сразу, срез единственной панели на платформу в целом не переносят.
Где эти записи смыкаются
Совпадение приходится на единый объект — конкретный адрес. Журнальная строка подтверждает отдачу файла роботу платформы, поле выдачи — её появление рядом с репликой. Такой стык сужает круг проверяемых вопросов, вывода о причине не даёт: наблюдаема здесь совместная встречаемость, механика выбора скрыта.
Сверка требует подготовки. Адреса выравнивают заранее: завершающий слэш, регистр, лишние параметры запроса размножают один путь в целый ряд строк. Границы окна совмещают тоже — журнал за сутки и панель соседнего периода говорят о разном.
Обе стороны сводят в общую сетку: напротив каждого материала отмечают обход, выход в источники. Клетки читают так:
- отметки совпали — адрес подтверждён с двух сторон;
- страница отдана, в опорном слое не всплыла — разбирают сам материал;
- журнал пуст, ссылка в выдаче есть — перепроверяют подпись агента, рамки окна;
- обе графы пусты — наблюдений по странице нет.
| Наблюдение | Откуда берётся | Какой вывод выдерживает |
|---|---|---|
| Бот платформы заходил | серверный лог | визит состоялся; об интересе системы к площадке строка молчит |
| Материалы отданы без ошибок | тот же лог | помех со стороны хостинга тогда не видно |
| Адрес назван среди источников | поле выдачи | домен оказался в опорном слое по заданному запросу |
| Бренд назван текстом | сам текст ответа | текстовая узнаваемость; о цитировании слой умалчивает |
| Отданная страница позже нашлась в опорах | лог вместе с выдачей | адрес виден с обеих сторон; причинности тут нет |
Практический смысл сведения — локализация спора до страницы. Претензия «нас нигде не цитируют» распадается на перечень конкретных материалов, по каждому известно: дошёл ли до него робот, встречался ли адрес в источниках. Разговор идёт адресами, а не сводным баллом.
Чего по этой системе проверить нельзя
Границы жёсткие, обойти их нечем:
- Порядок отбора. Что взято и по какому признаку — закрытая зона сервиса. Наружу выходит результат, сама процедура остаётся внутри.
- Содержание промежуточных поисков. Формулировок платформа не раскрывает, восстановить их по найденным ссылкам не получится: соответствие между запросом и найденной страницей неизвестно.
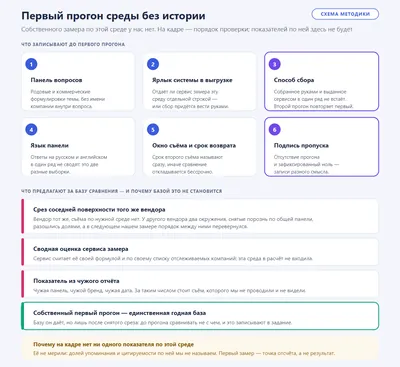
- Повторяемость. Повторных прогонов того же опросника у нас нет, поэтому про завтрашний день сказать нечего — перед нами моментальный снимок.
- Чужие свойства. Нулевая графа контентного обхода у остальных вендоров сказана про те же дни и про единичный проект; природой их сервисов она не становится.
- Переход от цитирования к рекомендации. Опора на домен означает ровно это: ни совета в чью-либо пользу, ни визита человека она не обещает.
Спросите нейросеть о нашем GEO-аудите
Что из этого забрать в работу
Сведение двух записей сужает неопределённость до адреса и даты — большего оно не обещает. Состав опор виден, подбор их скрыт; приход бота зафиксирован, побуждение в запись не попадает. Из этого складывается анализ видимости бренда в Perplexity: лог сверяют с перечнем взятого при неизменном опроснике. Дальше работа адресная: пройти отданные страницы, сверить их с опорами.
Обе стороны по собственному домену и панели запросов покажет аудит видимости сайта в нейросетях: журнал визитов рядом с перечнем того, что система взяла в ответ.
Что спрашивают про аудит сайта под Perplexity
Бот забрал десятки статей — почему в источниках попадаются далеко не все?
Обход и выбор опоры — вещи несхожие, связь между ними наши данные не раскрывают. Журнал говорит об отданном документе, поле выдачи — о составе взятого; совпадение бывает частичным. Читают оба слоя по неизменной панели: её правка подменяет выборку, смазывает сравнение.
Нужны ли серверные журналы, если замер видимости уже сделан?
Да. Выгрузка описывает день, строки лога — приходы роботов. Без них серверную сторону восстанавливают по косвенным признакам, спор о доступности материалов упирается в догадки. Вдвоём они закрывают каждая свою половину картины.
Правда ли, что этот сервис читает сайты охотнее остальных?
Нет: наблюдения одной площадки за несколько суток для утверждения о системах мало. Корректнее так: в том окне её краулер уходил к статьям глубже прочих AI-ботов, обучающие сборщики крупных разработчиков остались вне содержательного раздела. Чем заняты агенты прямого отклика, данные не показали.
Разрешение в robots.txt повышает шансы попасть в источники?
Разрешающее правило лишь снимает запрет, роль его этим исчерпана. У проекта отдельных правил под AI-ботов не стояло вовсе — они попадали в ту же группу; нарушений журнал не содержит, при этом часть разрешённых ботов за окно наблюдения так и не пришла. Снятый запрет делает обход возможным; дальнейшее мерится порознь.
Можно ли сравнить результат с будущим месяцем?
Для сопоставимости панель запросов, набор платформ, глубину журнала и способ счёта закрепляют одинаковыми заранее. Поменялась панель — новое расхождение будет про выборку, причина сдвига из такой пары уже не читается.
 GEO-аудит сайта для Алисы и Яндекс AI-поиска
 GEO-аудит сайта для Google AI Overviews: видимость, цитирование и источники
 GEO-аудит сайта для DeepSeek: анализ видимости и упоминаний
 GEO-аудит сайта для Claude: анализ видимости и цитирования
 GEO-аудит сайта для Google AI Mode: видимость бренда, источники и AI-выдача
 GEO-аудит сайта для ChatGPT: видимость, упоминания, цитирование и конкуренты
 GEO-аудит сайта для Gemini: анализ видимости бренда и источников
 Как попасть в ответы и рекомендации нейросетей: что можно улучшать
 Аудит сайта с помощью ИИ: что нейросеть может проверить, а что нет
 Что входит в GEO-аудит сайта и что он показывает