Цитируемость сайта в нейросетях: как измерять AI Citations
Что считается цитированием домена, чем оно отличается от упоминания, как его измеряют и какие развилки методики меняют итоговое число.

Коротко
- Цитирование — это факт попадания домена в список источников, который нейросеть показывает рядом с ответом. Назвала ли она при этом компанию, метрика не описывает: сноска и прозвучавшее имя считаются отдельно.
- В наших замерах сноска срабатывала чаще имени: домен попадал в число опор, а название компании при этом не произносилось. Пропорция меняется по нишам и платформам, поэтому правила из неё не выводится.
- У показателя две единицы счёта: доля ответов со ссылкой на домен и валовое число попаданий за период. Валовая цифра растёт вместе с выборкой, поэтому без знаменателя, панели запросов и даты она пуста.
- Итог меняют несколько развилок учёта: считают по домену или по отдельным адресам, сливают ли дубли, берут сырой журнал или просеянную выборку. Поэтому спрашивать нужно не «сколько», а «по какой таблице посчитано».
- Цитирование не означает ни согласия системы с содержанием страницы, ни узнаваемости бренда, ни переходов на сайт: чтобы перейти, человек должен сам раскрыть список источников.
Цитирование — попадание адреса сайта в перечень источников под ответом нейросети. О названии компании платформа вправе умолчать: сноска и прозвучавшее имя — несовпадающие события, замер держит их врозь. Цитируемость в нейросетях (AI Citations) описывает ровно этот узкий факт: как часто домен служит такой опорой, независимо от соседства с названием владельца. По нашим наблюдениям на нескольких замерах сноска срабатывает чаще имени: домен попадает в опоры ответа, а название владельца в тексте не звучит. Пропорция гуляет по нишам и платформам, правилу взяться неоткуда. Следствие: высокая цитируемость оставляет узнаваемость недоказанной. Читателю достаётся готовая выжимка; список опор лежит за кадром, пока он сам туда не заглянет.
Что считается цитированием, а что нет
Его фиксируют по единственному признаку: домен явно вошёл в список, откуда платформа собрала реплику. Нейросеть показывает такую подборку особой врезкой или отдаёт в технических данных, а сам текст имя владельца опускает. Запись молчит о качестве: согласие системы с содержанием лежит за её рамками. Публикация послужила материалом для фразы — и только.
Особняком стоит ссылка, вшитая прямо в тело реплики: подчёркнутое слово уводит наружу. Подсчёту это равноценно: связь с утверждением видна на месте. Но добывают её иначе — из разметки, минуя нижнюю врезку. Оба способа сбора мирно соседствуют, пока методика их различает.
Отдельная тонкость — что попало в подборку: адреса, откуда взяты фразы, или всё, просмотренное системой по дороге. Широкая трактовка щедрее: попасть туда получается без единой заимствованной строки. Различить списки снаружи удаётся редко, поэтому аккуратная методика оговаривает, какой из них считает, и следует выбору в дальнейшем.
Спорные случаи повторяются регулярно.
| Событие | Цитирование? | Почему |
|---|---|---|
| Домен есть в перечне источников ответа | да | — |
| Ссылка вшита в тело ответа | да | адрес назван и привязан к утверждению |
| Бренд назван текстом, источник не указан | нет | это упоминание |
| Ссылка всплыла в блоке «похожие материалы» | нет | не связана с содержанием ответа |
| Факт воспроизведён по памяти, минуя текущую страницу | нет | обучающие данные, не живой источник |
Граница держится на одном вопросе: попал адрес сайта в перечень этой реплики или нет. Где его утаивают — а так ведут себя немногие сервисы, — подтвердить нечем, и наблюдение честно выносят из расчёта.
Почему цитирование и упоминание расходятся
Снаружи разрыв выглядит так: текст реплики и список сносок живут порознь. Имя компании в тексте отсутствует, а домен в списке сносок стоит — и наоборот, имя звучит, сносок под репликой нет. Что происходит внутри, вендоры не раскрывают, и объяснять расхождение устройством генерации нам нечем. Зато видно другое: совпадения этих двух слоёв сервисы не обещают, и в наших замерах слои расходились регулярно.
Отсюда два несимметричных случая, оба нам встречались. Первый: адрес сайта попал в опоры, а имя компании в тексте не прозвучало. Второй: имя прозвучало, а публикации в перечне источников нет. Отчего вышло именно так, объяснения у нас нет: зафиксировано само расхождение.
Поэтому узнаваемость отсюда невыводима: чтобы дойти до публики узнаванием бренда, нужен лишний шаг — раскрыть сноски, заметить среди них нужную строку. Когда имя компании в основном тексте отсутствует, источник остаётся виден лишь в отдельном блоке ссылок. Ещё ограничение: иногда перечень скрыт вовсе, и тогда подтверждение держится лишь на совпадении содержания, а не на записи в журнале. Это важно тем, кто сверяет показатель с прошлым периодом: чтобы повторный замер оказался сопоставим, условия — панель запросов, набор систем, правила подсчёта — фиксируют заранее. Этим и занят аудит видимости сайта в нейросетях.
Как измеряют цитируемость
Счёт опирается на две единицы, смешение их искажает картину. Первая — доля: сколько реплик из панели запросов сослались на проверяемый адрес, к общему числу собранных. Без знаменателя цифра пуста: нужны неизменный опросник, состав систем, дата среза. Вторая единица — валовый счёт: сколько раз адрес сработал за период, вне привязки к доле. Такая цифра растёт вместе с объёмом выборки, а доля живёт самостоятельно: широкий охват даёт много вхождений при скромном проценте.
Окно наблюдения объявляют заранее: недельный и квартальный горизонты дают величины разного масштаба, склеивать их воедино бессмысленно. Короткое окно чувствительно к случайным колебаниям, длинное сглаживает свежие сдвиги.
Единицу учёта задают ещё две развилки, каждая меняет итог. Уровень: отсылка к внутренней странице зачисляется домену или живёт сама по себе. Развилка эта не умозрительная — от неё зависит, каким вообще увидят цитируемый контур ресурса. При счёте по домену контур сжимается до единственной строки, при счёте по адресам распадается на карточки, разделы, руководства, и становится видно, какая часть ресурса служит опорой, а какая простаивает. Дубли: бывает, что опорой служат сразу две внутренние публикации, и такой случай сливают — либо удваивают. Вдобавок список упорядочен, верхняя строка весит для публики больше последней.
Ещё одна развилка — густота перечня. Попадание в короткую выдачу весомее места в длинном хвосте, но строгий подсчёт разницу огрубляет до простого «присутствует». Методика, которая густоту учитывает, фиксирует правило нормировки заранее — ради сопоставимости прогонов.
Знаменатель меняется вместе с типом запросов в панели. Сценарий выбора поставщика и справочный вопрос о термине дают непохожий состав ссылок, а слияние их в общую долю искажает итог: коммерческая подборка со справочной идут порознь, иначе сильный результат по коммерческим прячет провал по информационным.
До прогона закрепляют и прочие условия, иначе сравнение со следующим замером бессмысленно: совпадающие формулировки, тот же набор систем — соседние расходятся кратно, устройство разброса разобрано у нас особо, — и точка отсчёта: та же панель спустя месяцы способна дать другую картину.
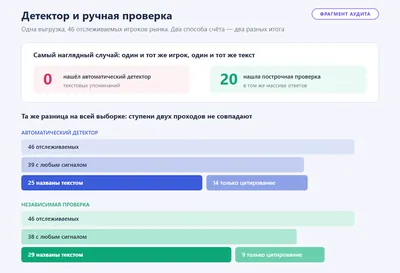
Последняя развилка: что технически зачтут — сырой журнал обращений или просеянную выборку из него. Слово «цитирование» внутри единой выгрузки умеет означать несхожие таблицы с расходящимися числами, а «из какой таблицы» важнее «сколько».
Типичные ошибки при чтении цитируемости
- Цитирование принимают за рекомендацию. Домен среди источников значит ровно одно: он там есть. Превосходства над конкурентами такая запись не удостоверяет.
- Складывают его с упоминанием. События разные, порой пересекающиеся, порой нет; сумма раздувает картину.
- Сравнивают сервисы вразнобой. Соседние расходятся кратно даже на одинаковом списке вопросов.
- Берут знаменатель, минуя тип запросов. Коммерческий интерес и справочный живут по отдельности, слияние прячет разницу.
- Считают по странице, а судят о целом ресурсе. Пока уровень учёта молчит, пара записей об одном домене выглядит единственным попаданием или двумя.
- Разовый прогон выдают за тенденцию. Та же формулировка завтра способна собрать иной состав сносок; показатель читают сериями.
- Смешивают несхожие журналы. Сырой лог и просеянная выборка — разные величины под общим словом; проверить вывод удастся лишь при указанной таблице.
Спросите нейросеть о нашем GEO-аудите
Вывод
Итог простой: домен либо попал в перечень источников, либо нет — такой факт и описывает эта метрика. Она молчит об узнаваемости, переходах, рекомендации: фрагмент пригодился при сборке, и всё. Читать показатель стоит с объявленным знаменателем, закреплённой панелью, типом запросов и датой среза, а сравнивать — с собственным прошлым замером по тем же условиям, а не с чужим числом вне контекста.
Разобраться, как цитируется конкретный сайт и что делать дальше, помогает проверка сайта под ИИ.
Вопросы и ответы
Если домен процитирован, значит, сведения на нём верны?
Неверно. Запись говорит о другом: материал пошёл в дело. Точность остаётся непроверенной — фрагмент мог оказаться устаревшим или вырванным из контекста.
Высокая цитируемость обязательно приводит к переходам на сайт?
Гарантия исключена. Переход происходит, только если человек сам раскрывает сноски, щёлкает по ссылке. Клики — отдельная метрика, и предсказать их отсюда нечем.
Годится ли разовый запрос для сравнения с конкурентом?
Формально да, но вывод останется узким: он показывает расклад на конкретную дату и формулировку. Устойчивое сравнение строится на серии запросов, а не на разовом совпадении.
Цитирование и присутствие бренда в структурном слое совпадают?
Величины независимые. Первое — про внешнюю опору, второе — про внутреннюю разметку.
Поднимет ли цитируемость частое упоминание бренда у себя?
Прямой связи мы не наблюдали. В список опор попадает то, что пригодилось при сборке, и частота собственного имени такого попадания не обеспечивает.
 Упоминания бренда и сайта в нейросетях: как анализировать AI Mentions
 Источники нейросетей: какие сайты цитируют AI и как стать источником
 Share of Voice в нейросетях: как считать долю голоса бренда в AI
 Репутация бренда в нейросетях: контекст, сравнения и AI Benchmark
 Мониторинг AI Visibility: как отслеживать видимость бренда в нейросетях
 AI Visibility сайта и бренда: как измеряется видимость в нейросетях
 Как провести GEO-аудит сайта и бренда: методика, этапы и чек-лист
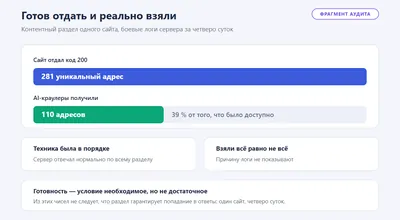 AI-ready аудит сайта: проверка готовности к AI-поиску и нейросетям
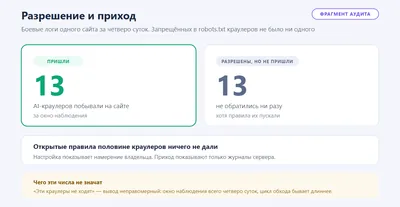 AI-краулеры и robots.txt: как проверить доступность сайта для нейросетей
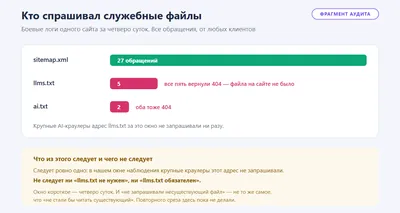 llms.txt для GEO: что проверять и как использовать на сайте