Упоминания бренда и сайта в нейросетях: как анализировать AI Mentions
Что считается упоминанием бренда в ответе нейросети, почему автоматический счёт и ручная проверка дают разные числа и как читать эту величину.

Коротко
- Упоминание — факт того, что название компании, имя продукта или её домен прозвучали в самом тексте ответа. Падеж, регистр, кавычки и место во фразе значения не имеют, оценки в метрике нет.
- Текст из технических блоков — подписей, сносок, кнопок — в зачёт не идёт, как и описание компании без названия: искать там нечего.
- Машинный детектор и ручная построчная сверка на одном и том же массиве регулярно давали разные числа. Причины две: перенос строки, записанный в выгрузке текстовым обозначением, и короткие алиасы, совпадающие с обиходными словами.
- Поэтому до подсчёта собирают список написаний — полная форма, сокращение, латиница, транслитерация, частая опечатка — и правило для омонимов, одинаковое для себя и для конкурентов.
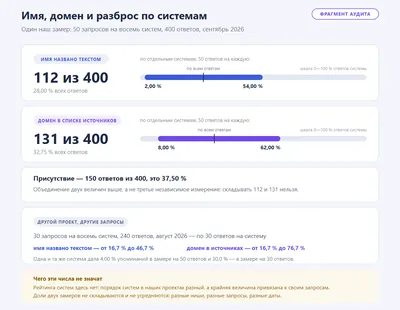
- Доли считают по каждой площадке отдельно: среднее по всем скрывает системы, где бренд не прозвучал ни разу. Нулевой результат детектора — повод просмотреть выборку глазами, а не вывод об отсутствии.
Упоминания бренда в нейросетях — случаи, когда имя компании, название продукта или адрес сайта прозвучали в тексте ответа. AI Mentions бренда измеряют реплику: слово встретилось — величина зафиксирована, сноски, технические блоки рядом её не меняют. Показатель отвечает на единственный вопрос: называет ли система бренд вслух, отвечая по его теме. Цитирование смотрит в другую сторону — на домен в перечне источников. Главная трудность лежит глубже разницы двух метрик: наши замеры дали несовпадающие числа на общем массиве — машинный детектор посчитал не так, как ручная построчная сверка. Причины технические и языковые, обе коренятся в правилах поиска.
Что считается упоминанием бренда, а что нет
В зачёт попадает название компании, продукта или узнаваемый алиас, появившиеся в тексте реплики, минуя разметку. Падеж и форма безразличны: годятся именительный, косвенный, сокращённая запись — лишь бы контекст снимал сомнения. Регистр букв и кавычки роли не играют. Оценка, сноска, место среди рекомендаций безразличны: достаточно самого факта. Счёт охватывает абзац целиком, включая вводные обороты и финальные оговорки. Упоминания сайта в нейросетях разбирают особо: там звучит доменный адрес вместо имени владельца, но мерка та же. Описание без имени в расчёт не идёт: искать нечего, догадка остаётся догадкой. Производные — уменьшительные, профессиональный жаргон, бытовые сокращения — зона спорная: решение по ним принимают заранее и заносят в список — следующий заход соберут по той же мерке. Надпись из технических блоков — подписи, сноски, кнопки — остаётся разметкой, не речью.
| Ситуация | В зачёт? | Почему |
|---|---|---|
| Компания названа в середине фразы | да | произнесено вслух |
| Марка открывает строку перечня | да, но разбор её иногда теряет | причина ниже |
| Процитирован домен, а не владелец | нет | это цитирование, другая метрика |
| Алиас совпал с корнем обиходной лексики | нет, если смысл чужой | нужен контекст, а не подстрока |
| Обозначение стоит в косвенном падеже | да | та же лексема, другая словоформа |
| Марка соседствует с конкурентом | да | тональность фразы ничего не меняет |
Тональность и место среди остальных игроков — соседние разрезы. Здесь фиксируют факт; каким он получился, выясняют отдельно.
Почему автоматический счёт и ручная проверка расходятся
Машинный разбор выгрузки и построчный просмотр совпадающего массива регулярно расходились при неизменной панели запросов. Разошлись способы подсчёта, величина осталась собой: искали одно, нашли разное.
Первая причина техническая. Внутри выгрузки перенос строки иногда записан текстовым обозначением вместо управляющего символа, прямо посреди абзаца. Модели перечисляли поставщиков столбиком; первое имя вставало сразу за таким обозначением. Поиск по границе лексемы, настроенный на привычный разрыв, в этой точке пропускает искомое: строка для него продолжается непонятным набором символов. Так возникал нулевой итог, хотя глазами находилось заметно больше.
Вторая языковая. Короткие алиасы совпадают с корнем обиходной лексики. Поиск подстроки без границы путает искомое с посторонней лексемой либо пропускает нужную словоформу: падежные окончания у имени собственного ведут себя подобно существительному. Дефект единой природы уменьшает находки здесь, добавляет лишние там, поэтому результат зависит от выбранного способа.
Отсюда подготовительный шаг — список написаний, собранный до подсчёта. Туда входят полная форма, сокращение, латиница, кириллица, транслитерация, слитное и дефисное начертание, частая опечатка. Рядом лежит правило для омонимов: при каком соседстве находка идёт в дело, при каком остаётся простым созвучием. Правило записывают заранее, применяют равно к себе и к остальным участникам рынка, иначе два захода разойдутся на общем материале. Настройки пишут в тот же файл: чувствительность к регистру, границы токена, перечень разделителей. Спорные случаи выносят отдельным перечнем и решают глазами: автоматика выдаёт повод проверить, а не вердикт.
Единицу счёта задают до прогона и держат неизменной. Подмена на полпути рождает спор о числах: дальше сравнивают несравнимое.
Проверку поручают человеку, который видит исходный абзац целиком, а не вырезку вокруг находки: вырезка прячет соседство, по которому решают спорный случай. Сверяют выборку — все нули и часть остального. Набирают её по жребию, иначе внутрь попадают удобные случаи. Доля выборки стоит рядом с итогом, чтобы сверку не приняли за полную. Расхождение само по себе — не брак разбора, его тоже фиксируют: в отчёте стоят две цифры, способ получения каждой, дата. Тогда следующий замер сравнивают с однотипным.
Анализ упоминаний: знаменатель, единица счёта и мониторинг
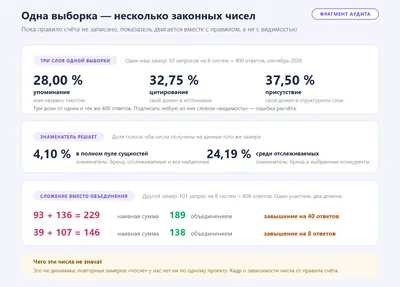
Анализ упоминаний бренда в нейросетях начинается с развода единицы и знаменателя. Единица — один ответ: имя в нём либо прозвучало хотя бы раз, либо нет; повторы внутри долю не двигают. Знаменатель — вся панель реплик, собранная за выбранное окно на фиксированном наборе площадок; ни число слов, ни количество подзапросов, в которые модель веером разворачивает исходный вопрос, в расчёт не идут. Доля — отношение числа зачётов к размеру панели. Сопоставима она только при прежних условиях: те же площадки, прежние формулировки, равное по длине окно. Окно подписывают датами — «недавно» в отчётах читают по-разному.
Счёт грубее, чем кажется, — для факта называния нормально: марка в длинном столбце и она же единственным советом весят равно. Разрез «в каком окружении» — иная процедура. Доли по площадкам держат раздельно — усреднение прячет полное молчание.
Воспроизводимость держится на протоколе: дата захода, формулировка каждого запроса, язык, сохранённый экранный снимок. Протокол хранят рядом с выгрузкой: в переписке он теряется. Снимок нужен затем, чтобы спорную запись перечитать через месяц, — без архива разговор о расхождении упирается в память. Подписывают его временем, не номером. В ответе на брендовый вопрос название обычно звучит вслед за ним; такие повторы отделяют от прочих, иначе итог задаёт сама формулировка.
Мониторинг упоминаний бренда в нейросетях стоит на том же: повторный замер воспроизводит набор площадок, список запросов. Иначе разницу объяснит подвижная панель: узнаваемость тут ни при чём. Чтобы два прогона оказались сопоставимы, площадки, формулировки, порядок подсчёта фиксируют заранее — на этом и держится GEO-аудит под нейросети.
Типичные ошибки при чтении этой метрики
- Называние принимают за рекомендацию. Запись удостоверяет звучание имени, молчит о превосходстве над конкурентами.
- Нулевой машинный итог читают как полное отсутствие. Где детектор молчит, выборку просматривают глазами — причины молчания разобраны выше.
- Величину складывают с цитированием. События разные: слово в тексте и домен в источниках.
- Разовый прогон по одной площадке выдают за устойчивый рейтинг. На коротком наборе запросов система щедра на имена, на длинном скупа; перенос вывода с ниши на нишу ничем не подтверждён.
- Звучание путают с присутствием в структурном слое — у присутствия своё определение и свои данные.
- Разовую проверку принимают за тенденцию без серии однотипных заходов.
Спросите нейросеть о нашем GEO-аудите
Вывод
Упоминание — текстовый факт называния, а не оценка и не место в источниках. Чтобы прочитать его верно, фиксируют знаменатель, способ поиска и правило отбора, а затем перепроверяют результат там, где он выглядит нулевым или неправдоподобно щедрым: расхождение детектора и ручного просмотра на общем массиве мы встречали регулярно — это повод к сверке, а не к отказу. Увидеть, как и где конкретное название звучит у разных площадок, помогает анализ AI-видимости.
Вопросы и ответы
Если бренд назван в ответе, значит, его рекомендуют?
Нет. Называние говорит ровно одно: слово прозвучало. Оценка, сравнение, рекомендация в эту величину не входят — контекст фразы разбирают иной процедурой.
Можно ли доверять одному машинному отчёту мониторинга без проверки?
Отчёт — отправная точка. Детектор и построчный просмотр расходятся из-за хранения переносов и совпадения алиасов с обиходной лексикой, поэтому цифру сверяют выборочно глазами, особенно при нулевом показе.
Имя конкурента в той же реплике важнее собственного?
Это соседний разрез — про окружение, не про подсчёт. Считают их равно: по букве, без оценки, кто выглядит выгоднее. Марка, прозвучавшая в чужом абзаце о конкуренте, тоже идёт в зачёт: правило смотрит на запись, не на героя фразы.
Адрес сайта считают так же, как бренд?
Да, разница только в искомой строке: скрипт ищет либо имя компании, либо домен. Встретился адрес вне перечня источников — его зачтут отдельно от цитирования.
 Источники нейросетей: какие сайты цитируют AI и как стать источником
 Share of Voice в нейросетях: как считать долю голоса бренда в AI
 Репутация бренда в нейросетях: контекст, сравнения и AI Benchmark
 Мониторинг AI Visibility: как отслеживать видимость бренда в нейросетях
 AI Visibility сайта и бренда: как измеряется видимость в нейросетях
 Цитируемость сайта в нейросетях: как измерять AI Citations
 Как провести GEO-аудит сайта и бренда: методика, этапы и чек-лист
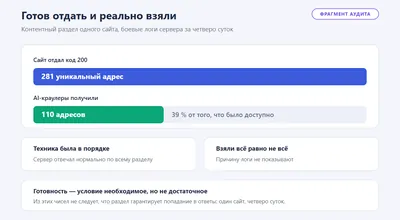 AI-ready аудит сайта: проверка готовности к AI-поиску и нейросетям
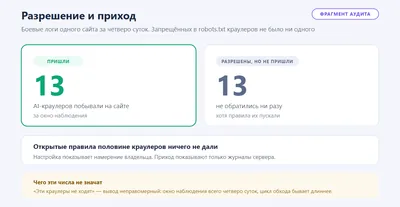 AI-краулеры и robots.txt: как проверить доступность сайта для нейросетей
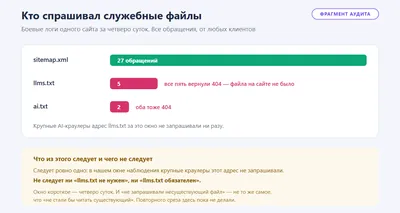 llms.txt для GEO: что проверять и как использовать на сайте