Источники нейросетей: какие сайты цитируют AI и как стать источником
Из чего состоит пул источников, на которые опираются ответы нейросетей, почему попадание в него не равно попаданию в ответ и как этот состав измеряют.

Коротко
- Набор источников нейросети не повторяет поисковую выдачу: наверх здесь выходят карты, каталоги, нормативные реестры и местная пресса — площадки, которые за коммерческий топ обычно не борются.
- В одном нашем замере основную долю пула занял общий справочный контур, а сайты участников рынка заняли малую часть. На любую отрасль это наблюдение не переносится.
- Попадание домена в пул за период и цитирование в конкретном ответе — разные события. Бывает и наоборот: страницу процитировали однажды, но устойчивой частью выборки она не стала.
- Домены, уникальные адреса и сами цитирования считают на трёх отдельных уровнях. Складывать их нельзя, а длинный список доменов без распределения частот остаётся инвентарём, а не картиной.
- Замер держится на протоколе: опрашиваемые сервисы, формулировки, число прогонов, границы окна и правило зачёта цитирования. Без него непонятно, сдвинулась выдача или переписан вопрос.
Источники нейросети — сайты, чей материал модель задействует при сборке ответа, плюс адреса, вынесенные в ссылки. С поисковой выдачей набор не совпадает. Выдачу делят участники рынка, соревнуясь за место под запрос. Наверх здесь выходят реестры, карты, нормативные базы, местные газеты — за коммерческий топ они обычно не борются. Критерий попадания другой: достаточно, что текст пригодился при сборке. Обгонять соперников по релевантности незачем.
Ниже разобрано четыре вещи: из каких типов площадок складывается эта совокупность; почему присутствие в ней лишь отчасти предсказывает исход конкретного обращения; что это означает на практике; как выборку измеряют, чтобы ниши сравнивались корректно.
Из чего состоит пул источников
Конкуренты занимают главное место редко. Наш замер показал обратное: основную долю набрал общий рыночный контур — картографические сервисы, отраслевые каталоги, сравнительные витрины, нормативно-правовые реестры, районная пресса. Участникам рынка досталась малая часть. Переносить находку на любую отрасль нельзя: вес инфраструктурного контура скорее сопутствует тому, насколько тема регулируется, насколько густо покрыта справочниками, насколько ею занимаются местные редакции.
| Тип ресурса | Что входит | Чем полезен |
|---|---|---|
| Картографические сервисы | карточки организаций в навигационных приложениях | адрес и координаты даны структурированной записью |
| Каталоги и агрегаторы | рубрикаторы, доски объявлений, витрины сравнения | общий список многих поставщиков услуги |
| Нормативно-правовые реестры | базы стандартов, лицензионные своды, законодательство | проверяемое утверждение о статусе, лицензии, требовании |
| Отраслевые медиа | профильные издания и справочные порталы | обзоры и разборы, охватывающие предмет целиком |
| Локальные медиа | районные газеты, городские порталы | сюжеты с привязкой к району |
| Собственные каналы | сайт, профили в соцсетях, корпоративный блог | редакционный контроль принадлежит организации |
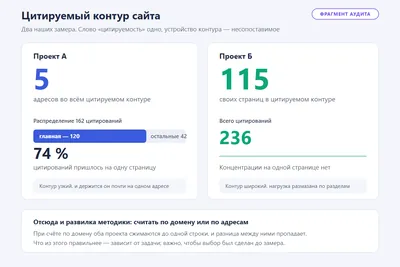
Доля своей площадки сильно расходится по проектам. Где-то весь цитируемый контур сводится к горстке адресов, причём с явной концентрацией на единственной странице; где-то раздел разворачивается на сотню с лишним документов. По количеству страниц о весомости судить нельзя: концентрация может означать, что пригодный к цитированию фрагмент лежит именно там, а прочие разделы просто выпали из фокуса текущего периода.
Отдельного внимания стоит внешний след за пределами своих каналов. У части проектов площадок, подтверждающих присутствие независимо, почти не нашлось: то, что выглядит внешним, при разборе оказывается корпоративным каналом компании под другим именем. Поэтому критерий независимости проговаривают заранее: иначе в зачёт могут уйти перепечатки и партнёрские врезки, где материал остался авторским. Расклад конкретного сайта — не средний по типу ресурса — покажет анализ AI-видимости.
Почему попадание в пул не равно попаданию в ответ
Домен попал в измеренную выборку за взятый интервал — цитирование отсюда вытекает лишь отчасти. Конкретный ответ собирается под единичную формулировку здесь и сейчас, а выборку фиксирует наблюдение над целой панелью запросов. Срезы совпадают частично. Бывает и обратное: текст процитирован разово, но устойчивой частью выборки так и не становится — следующая проверка с иным составом вопросов его минует.
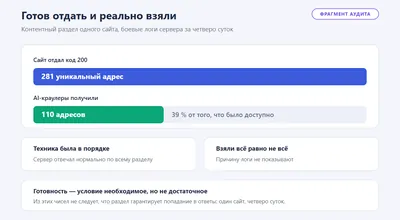
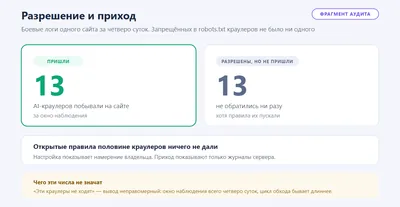
Разбор серверных логов добавляет третий ракурс: AI-краулеры заходили в контентный раздел заметно активнее прочих. Наблюдение говорит лишь о плотности визитов в этот отрезок, и большего не обещает: дошедшее оттуда до читателя журналу обращений неизвестно.
Что значит «стать источником» на практике
На практике смысл узкий: домен оказался среди материалов, задействованных моделью при подготовке ответов за взятый период — текстом, ссылкой либо сразу обоими способами. Позиции, тональности упоминания, повторного цитирования это не обещает. Повторный прогон способен дать иную картину: частоту переоценки контура вендоры не раскрывают, серий замеров подряд по проекту у нас нет, и переносить единичный результат на будущее рано.
Весь интент темы попадание не закрывает: по информационным запросам присутствие бывает, а в соседнем коммерческом сегменте — ни разу. Слои разные, сводить их воедино неправомерно.
Как измеряют состав пула источников
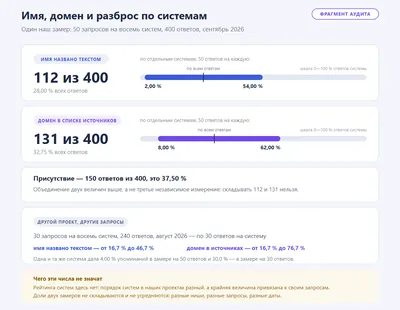
Единиц счёта несколько. Домены, уникальные адреса, цитирования считают по отдельности — это три разных уровня. Карточка реестра, профиль агрегатора, витрина сравнения услуг живут на общем домене, поэтому уровни неравнозначны. Третий уровень — случаи, когда платформа сослалась на конкретную страницу при сборке. Три величины держат раздельно: ни складывать их, ни подменять одну другой нельзя.
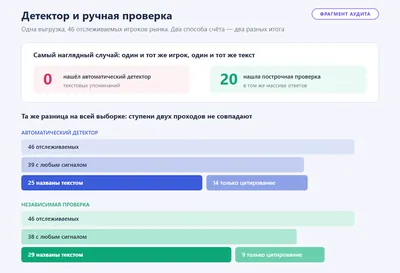
Способов два, и смешивать их не стоит. Первый разбирает выданное системой: заданная панель прогоняется, упоминания и ссылки размечаются. Второй смотрит со стороны сервера: кто заходил и сколько раз. Природа разная: первый показывает увиденное читателем, второй — забранное обходчиком. Забранное и процитированное не совпадают: посещённая страница остаётся неназванной, а названную журнал того же срока не зафиксировал.
Внутри списка нет порядка по весу. Площадка, запрошенная единожды, стоит в выгрузке рядом с той, к которой модель возвращалась постоянно; различает их счёт обращений, который ведут в особой колонке. Поэтому длинная роспись доменов ещё ничего не говорит: без распределения частот получается инвентарь, а не картина.
Типизацию выгрузка не делает — строки приходят без признака группы. Раскладка по видам (навигация, рубрикаторы, реестры, пресса, свои каналы) остаётся ручной работой аналитика, и правила раскладки тоже входят в протокол: иначе две описи разойдутся уже на группировке, когда городской портал один сочтёт прессой, а другой — рубрикатором.
Замер стоит на двух фиксациях: панель запросов и границы окна. Новая выгрузка не равна прошлой даже у одной платформы: данные обновляются, обработка меняется, а переход на другую тематику вытаскивает совсем иную подборку.
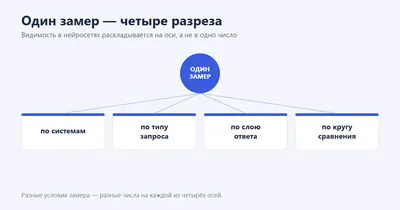
Сопоставимость держится на протоколе. До начала работы записывают: опрашиваемые сервисы, формулировку каждого вопроса, число прогонов, рамки периода, правило, по которому адрес признаётся процитированным. Протокол хранят рядом с выгрузкой — иначе позже не разобрать, сдвинулась ли выдача или дело в переписанной формулировке.
Отсюда и несопоставимость объёмов между нишами. Проверенные замеры разошлись на порядок по всем трём уровням счёта: рынок, плотно покрытый агрегаторами и картами, даёт список заметно обширнее, чем рынок, живущий отраслевой прессой и правовыми базами. Ради сравнимости повторной проверки с первой панель и окно фиксируют заранее, затем воспроизводят условия буквально; условия, собранные наново без системы, сравнение обнуляют.
Спросите нейросеть о нашем GEO-аудите
Вывод
Этот пул — смешанная подборка карт, рубрикаторов, правовых и медийных ресурсов плюс часть доменов самих участников рынка. Рейтинг компаний и поисковую выдачу он не повторяет. Источником домен делается ровно в одном смысле: он вошёл в подборку за заданное окно. Гарантии места в следующем прогоне это не даёт. Перед правкой контента под отдельные типы ресурсов полезно понять, что уже вошло в подборку по вашей теме и какую долю держит домен компании.
Если преобладают чужие справочники и каталоги, а своя площадка сводится к паре страниц, разумный шаг — GEO-аудит под нейросети: состав подборки и условия замера записываются так, чтобы следующую проверку удалось поставить рядом с этой на сопоставимых основаниях.
Вопросы про источники нейросетей
Чем этот пул отличается от карты сайта или ссылочного профиля?
Оба описывают устройство и репутацию отдельного проекта. Здесь же описана чужая инфраструктура темы — внешние площадки, втянутые в её ответы, где собственный домен остаётся строкой среди прочих.
Можно ли заранее перечислить площадки, которые нейросеть использует в вашей нише?
Нет: набор зависит от состава вопросов и календарных рамок, а устройство отбора вендоры не публикуют. Реалистичная задача другая — зафиксировать набор своей панели внутри своего окна, а потом сравнивать с последующими проверками на равных условиях. Таков практический смысл фразы «аудит источников AI»: повторяемая процедура, а не разовый снимок.
Если конкурент заметен в каталогах и на картах, доминирует ли он в ответах нейросетей?
Необязательно. Размещение обычно оформляется заявкой по правилам принимающей стороны, и известность бренда почти ничего там не решает. Устойчивое цитирование — самостоятельный результат; прямую связь с видимостью в справочниках наши данные не подтверждают.
Одинаков ли набор ресурсов у разных платформ?
Нет. В проверенных случаях поведение расходилось настолько, что усреднение в общий список неправомерно. Тяготение сервиса к определённому слою по трём проектам в трёх нишах устанавливать рано — вышел бы рейтинг платформ, а данных под него нет.
 Share of Voice в нейросетях: как считать долю голоса бренда в AI
 Репутация бренда в нейросетях: контекст, сравнения и AI Benchmark
 Мониторинг AI Visibility: как отслеживать видимость бренда в нейросетях
 AI Visibility сайта и бренда: как измеряется видимость в нейросетях
 Цитируемость сайта в нейросетях: как измерять AI Citations
 Упоминания бренда и сайта в нейросетях: как анализировать AI Mentions
 Как провести GEO-аудит сайта и бренда: методика, этапы и чек-лист
 AI-ready аудит сайта: проверка готовности к AI-поиску и нейросетям
 AI-краулеры и robots.txt: как проверить доступность сайта для нейросетей
 llms.txt для GEO: что проверять и как использовать на сайте