Share of Voice в нейросетях: как считать долю голоса бренда в AI
Доля голоса существует только вместе со знаменателем: одни и те же выгрузки дают разный процент при смене круга сравнения. Как выбирают этот круг, что считается единицей и какие ошибки чтения встречаются чаще всего.

Коротко
- Доля голоса показывает не количество упоминаний, а положение имени среди других участников внутри выбранного круга сопоставления. Без знаменателя эта величина не существует.
- Одни и те же выгрузки дают кратно разную долю: по узкому списку конкурентов и по всем встреченным названиям, где в делитель набегают справочники, медиа и местные фирмы.
- Круг сравнения собирают либо из заранее закреплённого перечня соперников, либо из всего найденного. Первый вариант может пропустить нового игрока, второй размывается случайными попаданиями.
- Стороны считают по одной единице, на одном пуле запросов и одних площадках, а написания названия заранее склеивают в одно имя. Иначе одна компания займёт в знаменателе две строки, а её вклад разделится надвое.
- Долей рынка этот процент не является: он описывает заметность внутри отобранной панели вопросов. Тональность ответов, объём спроса и прогноз на следующий прогон в него не входят.
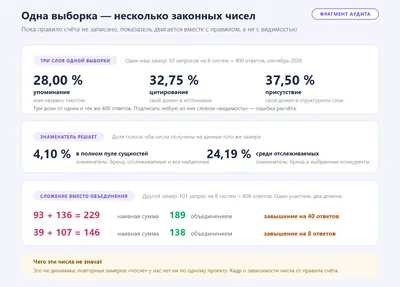
Share of voice в нейросетях — присутствие бренда в ответах языковых моделей, посчитанное относительно выбранного круга сопоставления. Абсолютное количество упоминаний здесь ничего не решает: весит то, как имя стоит рядом с другими на сквозном пуле запросов. Те же выгрузки дают разную долю при смене знаменателя: так устроена формула, к сбоям измерения это отношения не имеет.
Показатель легко спутать с двумя соседними: упоминаемость — текст, где названа компания, присутствие — её попадание в структурный слой. Доля голоса бренда в AI описывает третье: позицию имени среди прочих в заданной группе. Поэтому фраза «sov в нейросетях вырос» молчит о главном — за процентом скрывается произвольный состав конкурентов.
Почему число без названной базы сравнения бессмысленно
Величина существует исключительно вместе со знаменателем — смысловой частью формулы. Обновился перечень игроков — обновилась цифра, хотя само имя попадается в чужих текстах с прежней частотой.
Арифметика простая, подвох сидит глубже: числитель дают данные, делитель — принятое соглашение. Поэтому спор о десятых пункта осмыслен лишь после того, как описаны обе половины дроби.
Собственные замеры показывают расхождение на идентичных выгрузках: итог по узкому списку конкурентов кратно расходится со счётом по всем встреченным названиям. Во втором варианте в делитель набегают десятки посторонних строк — местные фирмы, медиаресурсы, справочники, формально привязанные к теме, далёкие от прямой конкуренции.
Отсюда правило чтения чужих отчётов: цифра без указанной базы ничего не доказывает. Вопрос «с кем считали» идёт впереди разговора о росте. Два отчёта с одинаковой методикой сбора, но несовпадающими перечнями выдают несопоставимые величины под общей вывеской.
Узнайте, что нейросети говорят о нашем GEO-аудите
Ответ формирует сама нейросеть.
Как выбирают круг сравнения: отслеживаемые игроки и все найденные сущности
Выборку собирают двумя способами, каждый по-своему меняет смысл расчёта.
Отслеживаемые соперники — заранее заданный перечень: прямые конкуренты, близкие по рынку фирмы, иногда отраслевой эталон. Такой счёт отвечает на узкую деловую задачу — как марка выглядит именно на этом фоне. Список закрепляют до старта и держат неизменным: правка задним числом подгоняет вывод под желаемый.
Все найденные сущности — любые организации, продукты, сервисы, которые модель назвала хотя бы раз на том же пуле запросов, независимо от начального плана. Такая выборка ближе к фактической картине поля, зато размывается случайными попаданиями — записями, которые за клиента всерьёз не соперничают.
Собственные прогоны показали смену состава от платформы к платформе: у каждой системы всплывал свой набор игроков при тех же формулировках. Перечень, собранный под одну нейросеть, при переносе на вторую обычно требует пересмотра — иначе часть реальных конкурентов выпадает из расчёта.
| Отслеживаемые соперники | Весь найденный круг | |
|---|---|---|
| Состав | закрепляется до замера, статичен в процессе | складывается по факту из найденного |
| Что показывает | позицию среди отобранных фирм | место среди всего, что система связала с темой |
| Риск | пропустить нового участника рынка | размыть смысл случайными попаданиями |
| Когда уместна | сверка с именованными соперниками | оценка плотности поля |
Переход между подходами редко оказывается разовым решением аналитика. Повод диктует сама работа: разбор перед переговорами с известным игроком требует точного перечня, быстрая разведка незнакомой темы — широкого захвата. Трудность возникает там, где выбор остаётся незадокументированным: правило кочует из презентации в презентацию без пояснения, откуда взялись имена. Поэтому рядом с выкладкой держат служебную карточку — дату прогона, дословные формулировки, язык интерфейса, площадки, автора. Через полгода прежний принцип отбора мало кто восстановит, а следующий аналитик, скорее всего, выстроит свою логику — непохожую на прежнюю ни отбором, ни арифметикой.
Из чего складывается знаменатель и что считается единицей
Знаменатель — сумма результатов участников по единому пулу фраз и площадок. Числитель — вклад изучаемой марки в ту же сумму. За единицу берут зафиксированное присутствие в ответе, отдельное от текстового упоминания: смешивать два слоя при расчёте нельзя. Одну сторону посчитали по упоминанию, другую — по структурному слою, и сумма теряет смысл: стороны собраны разными правилами.
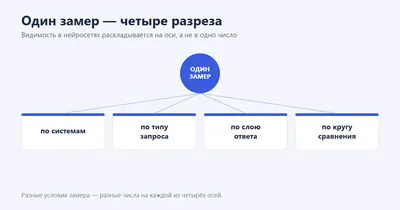
Второе обязательное условие — общий для сторон набор запросов и платформ. Строка из первого списка, строка из второго складывают два среза в единую цифру вместо измерения совместной видимости. С площадками тот же принцип: суммы по двум сервисам в одно число не сводятся.
Третье условие — нормализация написаний. Компания всплывает латиницей и кириллицей, с юрлицом и без него, в сокращении или целиком. Пока регламент не прописал, какие написания склеиваются в одно имя, фирма занимает в дроби два места, а её вклад делится надвое. Склейку выбирают до прогона, записывают в ту же карточку.
Отдельно оговаривают вес записи. В базовом варианте попадания равны: абзац о компании и имя в скобках весят одинаково, а порядок в перечислении подсчёт не учитывает. Упрощение тоже входит в регламент — за процентом стоит простая арифметика.
Типовые ошибки чтения
- Цифра без названной базы. Непонятно, изменилась ли заметность или только те, с кем сравнивали.
- Перенос расчёта с одной площадки на весь рынок. У каждого сервиса свой набор заметных имён, чужая выгрузка описывает только себя.
- Счёт сторон по разным единицам. Текстовое упоминание против структурного слоя — расхождение методик, а не разрыв в видимости.
- Чтение процента как доли рынка. Показатель описывает заметность на отобранных вопросах; распределение покупателей сюда не входит.
- Пропуск смены состава между замерами. Прибавка новых имён объясняет сдвиг не хуже гипотезы о росте.
Причина общая: отношение путают с самостоятельным числом, забывая про знаменатель, про правило подсчёта.
Что эта метрика не показывает
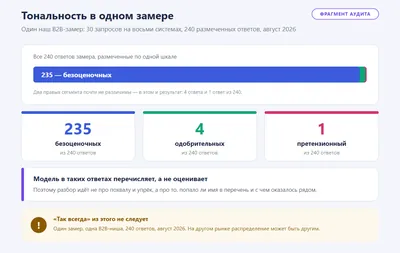
Величина обходит тональность: деление ответов на доброжелательные, нейтральные и критические решает отдельная задача. Совместная встречаемость имени с определёнными темами фиксируется как наблюдение, объяснение причины остаётся за кадром. Предсказательной силы у разового замера тоже нет: состав ответа на повторённый дословно запрос способен меняться между прогонами, а отдельный замер описывает лишь своё окно наблюдения.
За пределами этой арифметики лежит объём спроса. Высокая оценка на узком списке вопросов, скромная на широком — сочетание, возможное на той же выгрузке: итог зависит от широты захвата формулировок.
Спросите нейросеть о нашем GEO-аудите
Вывод
Метрика измеряет положение марки внутри выбранной группы — итог деления, целиком зависящий от подобранного состава и от набора фраз. Три вещи фиксируют до разговора о росте или падении: базу сравнения, единицу подсчёта и список площадок. Дальше их держат одинаковыми от проверки к проверке. Разовый счёт без такой фиксации даёт снимок момента, слабый как основание для выводов о динамике.
Проверить, какой получается эта величина для конкретной компании и какая рамка сравнения уместна, помогает GEO-аудит сайта: методика закрепляет правила подсчёта заранее, чтобы сопоставление с соперниками и повторные проверки опирались на одинаковые условия. Там же доступен аудит видимости сайта в нейросетях, который разбирает этот показатель вместе с остальными метриками видимости в ответах AI-систем.
Вопросы про долю голоса в нейросетях
Можно ли сравнивать результат бренда на разных платформах напрямую?
Только если круг сравнения и фразы совпадают буквально. Иначе сверять стоит сам факт видимости, а процент читать порознь по каждой системе.
Сколько имён должно попасть в круг сопоставления?
Универсального размера нет — его диктует работа. Сверка перед переговорами и обзор рынка требуют разного охвата. Важнее держать охват неизменным: иначе сдвиг снова объясняется им же.
Что считать «хорошим» результатом?
Единого порога нет: выбранная рамка задаёт всю шкалу. Десяток отобранных имён против случайно встреченных записей — несопоставимые диапазоны по определению.
Стоит ли включать компании, упомянутые системой один раз случайно?
Это решение методики, а не факт из данных. Разовая запись занижает счёт, не меняя реальной заметности марки, поэтому выбор закрепляют заранее и держат между проверками.
Чем этот показатель отличается от доли присутствия?
Доля присутствия измеряет бренд относительно общего количества ответов, без сопоставления с кем-либо. Метрика этой статьи ставит его рядом с остальными участниками, без них не существует.
 Репутация бренда в нейросетях: контекст, сравнения и AI Benchmark
 Мониторинг AI Visibility: как отслеживать видимость бренда в нейросетях
 AI Visibility сайта и бренда: как измеряется видимость в нейросетях
 Цитируемость сайта в нейросетях: как измерять AI Citations
 Упоминания бренда и сайта в нейросетях: как анализировать AI Mentions
 Источники нейросетей: какие сайты цитируют AI и как стать источником
 Как провести GEO-аудит сайта и бренда: методика, этапы и чек-лист
 AI-ready аудит сайта: проверка готовности к AI-поиску и нейросетям
 AI-краулеры и robots.txt: как проверить доступность сайта для нейросетей
 llms.txt для GEO: что проверять и как использовать на сайте