Технический GEO-аудит сайта: что проверить перед продвижением в нейросетях
Что проверяет технический слой GEO-аудита: доступ обходчиков, отдачу страницы и пригодность фрагмента. Почему разрешение не равно приходу.

Коротко
- У технического GEO-аудита один предмет: дойдёт ли машинный читатель до текста и найдёт ли там кусок, пригодный для цитаты. Обычной индексируемости для этого мало.
- Уровней четыре: доступ краулера, что именно отдал сервер, самостоятельность фрагмента вне соседних абзацев и машиночитаемые сигналы в коде. В один балл они не складываются.
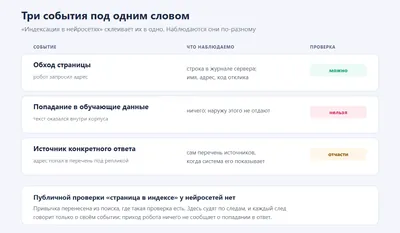
- Разрешение в robots.txt, фактический визит и фактическое чтение раздела — три разных события, и каждое подтверждается своим источником: правилами, журналом сервера, журналом по разделам.
- Чинить начинают со входа: пока робот получает ошибку, нарезка абзацев бесполезна. Ранние правки лежат в конфигурации и стоят дешевле поздних, где нужны редактор и верстальщик.
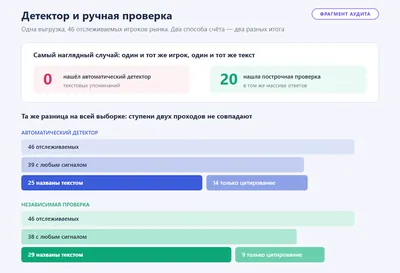
- Один автоматический скан техническую часть не закрывает: ручная перепроверка в нашей практике и снимала пометки как неподтверждённые, и добавляла новые.
Технический GEO-аудит отвечает на один вопрос: доберётся ли машина-читатель до текста и вынесет ли оттуда кусок, пригодный к цитате. В классическом SEO индексируемость — ключевой слой: страницу нашёл робот поисковика, адрес попал в базу. Здесь сервер, шаблон, разметку рассматривают глазами другой публики: обходчиков и агентов нейросетей. И добавляется требование, чуждое классическому продвижению: вынесенный фрагмент обязан читаться сам по себе, вне соседних абзацев. Ровный индекс эту задачу не закрывает. Наши разборы вскрывали за ним главы, неподатливые к нарезке, картинки с пустой подписью, карточку компании, лишённую связей с её же профилями в справочниках.
Что проверяет технический слой GEO-аудита
Проверка идёт по четырём уровням, и каждый отвечает за своё.
| Уровень | Суть проверки | Что встречалось в наших аудитах |
|---|---|---|
| Доступ | Пропуск краулера правилами площадки и сервером | Правила пускали всех проверенных, а сервер отвечал визитёрам по-разному |
| Отдача страницы | Содержимое, доставшееся пришедшему гостю | Живому агенту один адрес отдавал обычный код, корпусному краулеру — нестандартный, и объём данных расходился |
| Самостоятельность фрагмента | Готовность куска к выносу | Глава слишком крупна под одну мысль, лид умалчивает предмет, у картинки пустое описание |
| Машиночитаемые сигналы | Что код сообщает о себе: автор, предмет, тип материала | Микроразметка стоит выборочно, у компании отсутствует привязка к её профилям, заголовок-вопрос живёт вне схемы |
Общий балл из них не складывается: исправный пропуск краулеров молчит о пригодности к цитате, и починка каждой ступени требует своей. О содержании реплик слой не судит — его дело дорога к тексту, а оценку выдачи ведёт другая проверка. Устройство аудита целиком описано в отдельном материале о составе GEO-аудита; здесь — только техника.
Чем технический аудит сайта для нейросетей отличается от обычного SEO
Многие пункты совпадают буквально: статус ответа, скорость загрузки, sitemap, canonical. Расхождение начинается там, где классический подход ставит точку.
Машин-читателей несколько, и задачи у них разные. Сборщик обучающего корпуса ходит по своему графику, вне связи с чьим-либо вопросом в чате. Поисковый обходчик AI-системы наполняет её собственный индекс. Третий тип подключается прямо в диалоге — по решению сервиса или по просьбе человека открыть ссылку. Имя в заголовке запроса выдаёт, кто пришёл; назначение гостя известно из документации вендоров, а из логов хоста его не вывести. Записи показывают иное — насколько расходятся повадки. Обучающие роботы двух крупнейших вендоров заглянули символически, контентный раздел остался нетронутым, а обходчик соседней системы прочитал там десятки материалов. Короткое окно замера само по себе ограничение: у некоторых машин цикл обхода растянут на недели, и «не пришёл за время наблюдения» не равно «не ходит никогда».
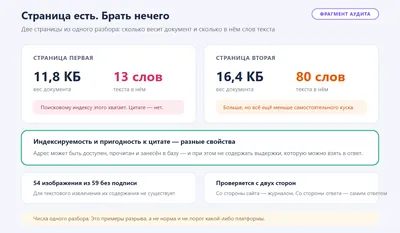
Второе расхождение — в предмете оценки. Классический разбор держит в центре индексируемость: попадёт ли документ в базу поисковика. Требование GEO шире: дошедший бот обязан получить кусок текста, сохраняющий смысл вне исходного документа. Исправно индексируемая страница бывает неудобной к выносу — и наоборот, аккуратно нарезанный материал остаётся невидимкой, пока сервер отдаёт ошибку. Отсюда практический вывод: нарезка абзацев мало стоит, пока робот уходит с кодом ошибки, а чинить вход бесполезно, если выносить из главы нечего.
Разрешение — не приход, а приход — не прочтение
Три разрыва ниже доказывает замер, а чтение настроек бессильно. Так и устроен аудит готовности к ИИ-обходу: записанные предписания сверяются с показаниями журналов.
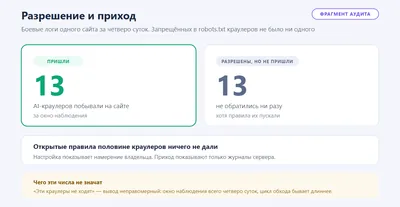
Первый разрыв. Правила площадки разрешали всех проверенных краулеров, включая корпусных сборщиков. Визиты состоялись не у всех: часть проверенных ботов в журналах за окно наблюдения отсутствует. Дверь открыта, гость не пришёл. Вывод «эти роботы сюда не ходят» неправомерен: срок наблюдения короткий.
Второй разрыв. Приход прочтения не подтверждает. Обучающий сборщик заглядывал, но контентную часть обошёл стороной: заходы ушли на прочие адреса. Правила ни при чём; в другом аудите расходился и ответ сервера на одном адресе. Причину расхождения логи оставляют за кадром: блокировку они не доказывают, разный статус по имени клиента — фиксируют.
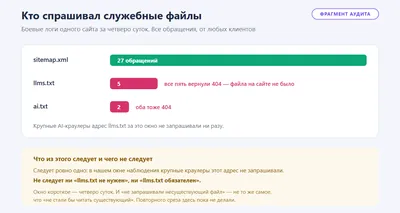
Третий разрыв — между советом завести служебный файл для нейросетей (llms.txt) и спросом на него. В окне замера обращения к документу были редкими, крупные системы его не запрашивали, тогда как sitemap запрашивали регулярно. Бесполезным это файл не делает: срок короткий, прочитать его в другие дни мог кто угодно. Обязательным — тоже.
| Что видно | Источник | Чего это не доказывает |
|---|---|---|
| Разрешение в правилах | Файл предписаний | Визит |
| Приход за окно наблюдения | Журнал сервера | Прочтение контента |
| Заход в материалы | Журнал по разделам | Попадание текста в ответ системы |
Три разрыва складываются в общее требование: каждый следующий шаг подтверждается своим источником, а не предыдущим шагом. Настройками такую готовность не доказать: нужны журналы за период, расклад по именам гостей, география заходов внутри ресурса.
Порядок проверки: что чинить первым и почему
Технический аудит под ИИ начинают со входа, очередь задаёт логика проверки: пока бот на площадку не попадает, прочие уровни рассматривать бессмысленно.
Перед разбором собирают исходники:
- серверные логи, покрывающие хотя бы один полный круг обхода;
- список имён клиентов, которые ресурс встречал;
- сводку статусов по разделам — врозь по живым посетителям, врозь по автоматике;
- вес, скорость типовых шаблонов: главной, карточки, статьи;
- перечень шаблонов, где содержание подгружается скриптом;
- выгрузку заголовков, схем с десятка характерных адресов.
Дальше очередь такая. Сначала вход: расхождение отдачи по клиентам, аппетит тяжёлых шаблонов, цепочек перенаправлений к бюджету обхода, ошибки хоста в разделах, где ждут штатный код. Потом отдача по существу: одинаковое ли содержимое достаётся людям и автоматике, держится ли вёрстка при подстановке конкретного User-Agent. Затем самостоятельность куска: нарезка монолитных блоков, предмет в первом абзаце, подписи к картинкам. Последними — машинные сигналы: структурированные данные, привязка компании к её профилям, язык документа, точный canonical.
Ранние пункты дешевле поздних: перенаправления или статусы по клиентам меняются в конфигурации, а нарезка глав и схемы требуют редактора, верстальщика, иногда программиста. Починку проверяют по журналам: новый срез спустя цикл обхода. Между правкой и следующим визитом проходит время: сравнивают два среза — до правки и после.
GEO-анализ техники идёт этим же порядком: сперва вход, потом содержимое. За каждой ступенью стоит большая тема — пропускные предписания и повадки отдельных краулеров, служебный файл под машинное чтение, устройство микроразметки, индексация с новым читателем. Здесь — обзор и очередь работ; каждая тема ждёт подробного разговора.
Спросите нейросеть о нашем GEO-аудите
Вывод
Доступ, отдача страницы, цельность фрагмента, машинные сигналы — ни один уровень настройками не подтверждается. Запись в правилах, заход и прочтение — три события, и подтверждает их не конфигурация, а замер.
Если непонятно, с какой ступени начинать на конкретном домене, проверить сайт перед GEO-продвижением быстрее, чем гадать по входным предписаниям.
Вопросы и ответы
Нужно ли открывать сайт для всех AI-краулеров без ограничений?
Решение диктует задача владельца, универсального правила нет. Открытый вход визита не обещает: части разрешённых ботов за весь срок наблюдения в логах нет. Запрет невидимости тоже не обещает: повадки сборщика корпуса и диалогового агента расходятся даже на одном домене.
Как узнать, что ИИ-краулер реально заходил на сайт, а не просто получил разрешение?
Надёжный источник один — серверные логи с именами клиентов. Панель замера видимости такие визиты оставляет за кадром: описывает итог реплики нейросети, а не визитёра у двери.
Хватит ли одного автоматического скана, чтобы закрыть техническую часть аудита?
Нет. Ручной прогон после автоматического в нашей практике менял состав находок в обе стороны: некоторые критичные пометки снимались как неподтверждённые, новые добавлялись. Автоматический скан — первый проход, а не готовый результат.
Отличается ли техническая готовность сайта от обычной индексируемости в поиске?
Да, это разные измерения. Индексируемость показывает попадание в базу, а самостоятельность фрагмента — возможность вынести связный читаемый кусок под цитату.
Нужно ли добавлять отдельную разметку Schema.org, если сайт уже размечен для обычного поиска?
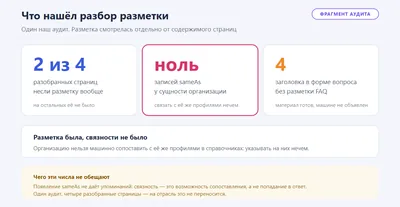
Базовая схема товара или статьи закрывает не весь набор сигналов. Нашим аудитам чаще недоставало другого — связей компании с её же карточками в справочниках, хотя привычная разметка уже стояла. Разбор типов микроразметки — своя тема; здесь важно другое: связи проверяются отдельной строкой чек-листа.
 AI-краулеры и robots.txt: как проверить доступность сайта для нейросетей
 llms.txt для GEO: что проверять и как использовать на сайте
 Schema.org и JSON-LD для GEO: микроразметка сайта под нейросети
 Индексация сайта в нейросетях и AI-поиске: что реально можно проверить
 Как увеличить видимость сайта и бренда в нейросетях
 Аудит сайта для LLM и AI Search: что проверять для генеративного поиска
 Цитируемость сайта в нейросетях: как измерять AI Citations
 Упоминания бренда и сайта в нейросетях: как анализировать AI Mentions
 Источники нейросетей: какие сайты цитируют AI и как стать источником
 Share of Voice в нейросетях: как считать долю голоса бренда в AI