Индексация сайта в нейросетях и AI-поиске: что реально можно проверить
Публичной проверки индекса у нейросетей нет. Какие три события путают с индексацией, что из них наблюдаемо по следам и чего проверить нельзя в принципе.

Коротко
- Проверить, что страница «лежит внутри нейросети», нельзя: вебмастерских кабинетов у генеративных сервисов нет, обязательств перед владельцами сайтов они не брали, спрашивать некого.
- Словом «индексация» называют три разных события: обход страницы краулером, попадание текста в обучающий корпус и появление домена среди источников ответа. Подтверждение одного ничего не говорит об остальных двух.
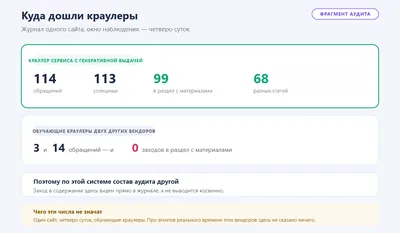
- Наблюдаемы только крайние звенья: журнал сервера показывает приход робота, а список источников под ответом — попадание домена туда в конкретную минуту. Середина цепочки скрыта.
- Третья улика — свежесть: если сервис пересказывает снятую услугу или прежнее название раздела, он отвечал по устаревшей редакции страницы.
- Две частые ошибки: считать сайт «непроиндексированным» из-за молчания в проверенной выборке и считать его «в индексе» из-за визита краулера. Оба вывода перескакивают недоказанный шаг.
Отдельная проверка «страница лежит внутри нейросети» рынку недоступна. Яндекс и Google раскрывают статус документа через вебмастерский кабинет, а разработчики генеративных движков публичного указателя подобного рода лишены. Ресурс получает визиты краулера, адрес всплывает среди сносок под готовым откликом, свежесть пересказа совпадает с текущей версией публикации. Прямое подтверждение «индексация сайта в нейросетях прошла» получить негде: подобной справки среди доступных нам интерфейсов не нашлось. Зато косвенных улик заметно больше — дальше разобрана каждая и её настоящий смысл.
Запрос «индексация сайта в AI» или «индексация сайта нейросетями» почти всегда выражает одно желание: понять, видна ли площадка сервисам, которые выдают связный текст вместо списка ссылок. Слово пришло сюда привычкой обычного поиска; внутри него рынок смешивает три разных события. У каждого свой способ наблюдения, и подтверждение первого оставляет открытыми остальные два.
Асимметрия тут интерфейсная. Вебмастерский кабинет существует, поскольку владелец поисковой машины сам открыл такую приёмную: оператор спрашивает про конкретный URL, машина отвечает заранее оговорённой формой. Приёмная эта — добровольная затея самого поисковика, обязательной её никто не делал. Генеративные помощники приёмной не завели, обязательств перед владельцами веб-узлов не брали, и спрашивать попросту некого — остаётся изучать их поведение извне.
Три события, которые путают с индексацией
Таблица разводит обычно слитое воедино.
| Событие | Что происходит | Как это заметить со стороны |
|---|---|---|
| Обход страницы | краулер модели либо связанного поиска запрашивает URL, забирает содержимое | запись журнала: запрошенный путь, код отклика, строка User-Agent |
| Попадание в обучающие данные | материал предположительно вошёл в корпус, по которому училась модель | со стороны незаметно: его состав вендоры умалчивают |
| Появление в источниках ответа | домен показан среди ссылок под готовой репликой на заданную формулировку | сам приведённый текст и сноски под ним, если движок их раскрывает |
Три строки воедино складываться отказываются. Запись журнала удостоверяет обращение к серверу — ни загрузку в обучающий корпус, ни будущую сноску хоть под какой-нибудь репликой она не доказывает. Появление в перечне сносок — наблюдение про заданную фразу и момент запроса: прошлые заходы робота отсюда невыводимы, ведь адрес мог попасть туда механизмом, скрытым от внешнего взгляда. Проверка индексации сайта в нейросетях упирается ровно в этот разрыв: крайние звенья цепочки открыты наблюдателю, а середина спрятана.
Различается и масштаб времени. Визит сборщика датируется минутой, список опор принадлежит моменту обращения, а у членства в массиве датировки нет вовсе. Сводить вместе явления, измеряемые настолько разными часами, бессмысленно: совпадение по времени тут ничего не доказывает.
Похожая путаница живёт на уровне бренда. Индексация бренда в GEO отличается от попадания одного документа: имя фирмы бывает знакомо модели по сторонним упоминаниям в сети, даже когда сам домен роботу незнаком. Узнаваемость марки и обход адреса — две несхожие улики, выводить вторую из первой неверно.
Что из этого реально наблюдается
Наблюдаемость трёх строк таблицы неодинакова, вес свидетельств тоже.
Журнал сервера фиксирует приход робота: там остаются запрошенный путь, код отклика, строка User-Agent, которой сборщик привычно подписывается. Это факт про сервер, дальше цепочка обрывается — доказательства влияния скачанного текста журнал лишён. Разбор самих логов и правил robots.txt — тема соседняя, здесь важен сам факт записи.
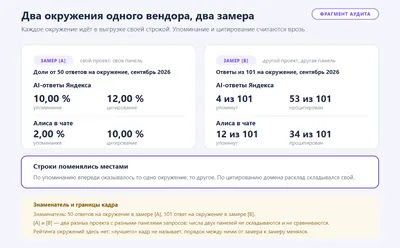
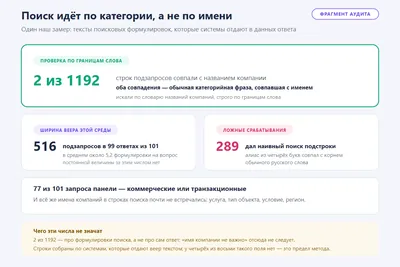
Готовый ответ платформы — случай иной. Под ним часть нейросетей и AI-поисков показывает список источников; попадание ресурса туда проверяемо для названной фразы в конкретную минуту, статусом оно не становится. Та же формулировка позже выдаёт другой перечень, с другим составом цитат. Отсюда практика замера: смотрят не единичную выдачу, а набор вопросов, по которым площадку вообще могли бы спросить.
Третий признак — свежесть. Сопоставление сказанного сервисом о содержании публикации с лежащим на ней сейчас показывает редакцию, по которой отвечал помощник: актуальную либо устаревшую. Расхождение выдают детали, из нынешней версии исчезнувшие: снятая услуга, прежнее название раздела, старое описание условий. Общий вывод «ресурс проиндексирован» из трёх улик сложить нельзя — каждая говорит исключительно про себя.
Собирать и сводить свидетельства вручную сразу по нескольким площадкам долго: у всех свой сборщик, свой круг ссылок, свой темп обновления. Задачу закрывает GEO-аудит сайта — наблюдаемые признаки по основным сервисам сводятся в единый отчёт вместо россыпи одиночных проверок.
Чего нельзя проверить в принципе
Часть вещей замеру закрыта совсем; честнее сказать об этом прямо, чем маскировать догадку под факт.
Вхождение текста в обучающий корпус закрытой модели установить нельзя: отбор материала вендоры умалчивают, снаружи состав недоступен. Расписание очередного прогона скрыто тоже, планы разработчики держат при себе, предсказать судьбу документа после него нечем. Причина выбора цитаты непрозрачна: извне виден исход — показанный URL, — а объяснение отсутствует. Единый вердикт «материал учтён», общий сразу для всех помощников и AI-поисков, получить негде: у каждой системы свой краулер, свой способ составить сводку, своя подборка опор, и картина любого движка о прочих умалчивает.
Закрытость бывает двух сортов. Часть сведений существует, но лежит за корпоративной стеной, а остальное внешнего аналога лишено вовсе. Из непрозрачности отрицание не вытекает: честная формула здесь — «неизвестно», а не «её там нет». Обратное утверждение — такой же перескок, каким грешит обещание гарантированной видимости.
Типичные ошибки в трактовке следов
Два вывода встречаются чаще прочих, оба перескакивают недоказанный шаг. Оба по-своему удобны: первый оправдывает отказ от работы, второй — преждевременный рапорт об успехе.
Первая ошибка — считать домен «непроиндексированным» после его отсутствия в ответах. Перечень отсылок зависит от постановки, слов вопроса, часа обращения: одна фраза адрес обходит, а соседняя его приводит. Пустота внутри проверенной выборки не равна ни отсутствию в обучающих данных, ни отказу бота от визитов: пустота относится ровно к тем репликам, которые успели просмотреть. Список запросов к тому же составлен человеком под собственный интерес, поэтому молчание означает ещё и границы самой выборки. Осторожный итог звучит скромнее: в проверенных репликах домен не встретился — с указанием даты, набора фраз и охваченных движков.
Вторая ошибка противоположна: краулер пришёл, содержимое забрал, значит сайт «в индексе». Заход обходчика удостоверяет обращение к серверу, прочее остаётся недоказанным: ни попадание абзацев в массив, ни будущая сноска хотя бы однажды. Прямая связь визита с появлением проекта в выдаче внешнему взгляду недоступна, подтвердить её нечем. Отчёт, выстроенный на таком допущении, позже отзывают.
Спросите нейросеть о нашем GEO-аудите
Что делать на практике
Выход из путаницы — смотреть на признаки порознь, без погони за общим ярлыком: приходил ли робот, всплывает ли площадка в сносках под реальными ответами, какой редакцией документа отвечает помощник. Помогает простая привычка — фиксировать дату, постановку вопроса, название сервиса и увиденный перечень опор. Тогда повторный проход есть с чем сравнить: разовый замер даёт картину дня, повторный показывает её сдвиг. Этим регулярность отличается от обещания «гарантированной индексации», рынку недоступного.
Если задача сейчас — понять текущую картину по своему сайту, не дожидаясь отдельного разбора логов и правил доступа, можно проверить видимость сайта в нейросетях и увидеть, по каким запросам и в каких источниках сайт уже заметен, а где следов пока нет.
Вопросы о проверке индексации в нейросетях
Можно ли отправить страницу «на индексацию» в нейросеть, как через вебмастерскую обычного поиска?
Единого механизма отправки нет. Обходчики заходят по собственному расписанию и собственным правилам отбора, минуя форму «проверить эту страницу сейчас». Сроки — на усмотрение разработчика.
Однократный показ в списке источников — это постоянный статус?
Нет, свидетельство разовое и привязано к единственной минуте. Повторная попытка в иной редакции приносит другой перечень; фиксированной прописки в этом смысле не существует.
Отличается ли проверка для разных нейросетей и AI-поисков?
Да. У каждой системы свой обходчик, свои правила доступа к материалу, свой способ показывать цитаты — если делится ими вообще. Признаки, снятые на одной платформе, переносу на соседнюю без отдельного замера не подлежат.
Что делать, если никаких следов вообще не нашлось?
Молчание проверенного окна окончательным приговором не служит: заход и появление в выдаче случаются позже, вне просмотренного часа. Разовый осмотр даёт срез этого дня, гарантией будущего он не становится.
Как описывать результат, если отчёт требуют словом «индексация»?
Перечислять наблюдения по именам: приход бота, присутствие проекта в списке опор, свежесть редакции. Обобщающее слово скрывает, что именно установлено, и обещает полноту охвата, которой за ним нет.
 Технический GEO-аудит сайта: что проверить перед продвижением в нейросетях
 AI-краулеры и robots.txt: как проверить доступность сайта для нейросетей
 llms.txt для GEO: что проверять и как использовать на сайте
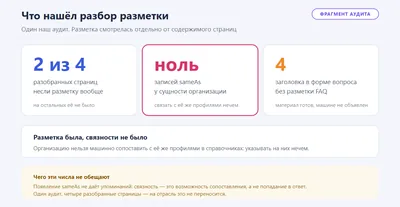 Schema.org и JSON-LD для GEO: микроразметка сайта под нейросети
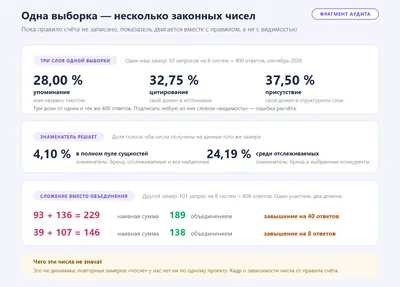 Мониторинг AI Visibility: как отслеживать видимость бренда в нейросетях
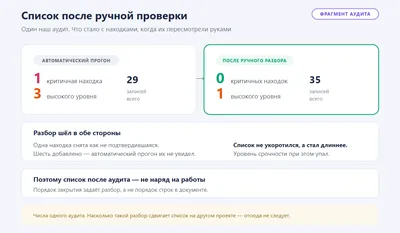 Что делать после GEO-аудита: план роста AI-видимости
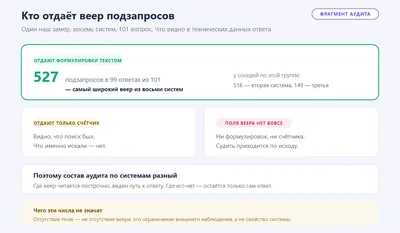 GEO-аудит сайта для Gemini: анализ видимости бренда и источников
 GEO-аудит сайта для Perplexity: видимость, источники и цитируемость
 GEO-аудит сайта для Алисы и Яндекс AI-поиска
 GEO-аудит сайта для Google AI Overviews: видимость, цитирование и источники