GEO-аудит сайта для DeepSeek: анализ видимости и упоминаний
В этой среде ответ редко бывает про вас одного: рядом с именем стоит широкий круг соперников. Поэтому двоичная отметка «назвали» здесь обманчива, и считать приходится плотность соседства.

Коротко
- В нашем B2B-замере ответы этой системы редко посвящались одной компании: чужих названий рядом с брендом здесь оказалось больше, чем у семи других систем на той же панели. Свойством платформы это не становится.
- Поэтому двоичная пометка о прозвучавшем имени мало что решает: в одну клетку она складывает и единственное названное имя, и имя, затерявшееся в длинном перечне.
- Плотность упоминаний конкурентов считают событиями, а не долей ответов, поэтому число бывает больше всей выборки. Делить события на ответы некорректно.
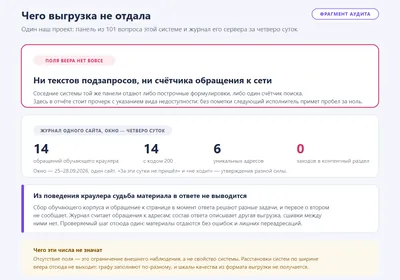
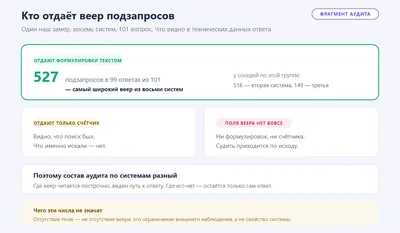
- Наружу эта платформа отдаёт только счётчик обращения к сети: факт поиска виден, сами формулировки — нет. Судить приходится по готовому тексту и перечню источников.
- В трёх наших замерах соотношение упоминания и цитирования у этой системы каждый раз складывалось по-своему. Ниши, панели и даты разные, поэтому рейтинга платформ из таких строк не выходит.
В нашем B2B-замере ответ этой системы редко оказывался посвящён одной компании: рядом с брендом набралось больше чужих имён, чем в любой другой из восьми проверенных систем той же панели вопросов. Так вышло на этом срезе, и свойством самой платформы такой счёт не становится. Отсюда главное отличие, которое вносит GEO-аудит для DeepSeek в привычный порядок проверки: отметка «имя прозвучало» решает мало — вес присутствия задаёт длина списка, внутри которого стоит имя.
Какой след система оставляет рядом с ответом
Платформенные разборы различаются тем, что система выпускает наружу вместе с готовым текстом. Часть систем отдаёт построчно поисковые фразы — развёртку исходного вопроса; другая выкладывает перечень найденных страниц; третий вендор держит несколько каналов порознь, и каждый мерят отдельной строкой.
Здесь наружу выходит счётчик: виден факт поиска, формулировки — нет. Счётчик удостоверяет сам поиск перед сборкой сводки, и этим исчерпывается. Дальше судят по исходу: готовому тексту и набору взятых источников.
Отсюда порядок работы: читают состав готовой сводки целиком, затем разводят слои учёта и считают каждый отдельно. Так и ведётся аудит видимости сайта в нейросетях по этой платформе.
Узнайте, что нейросети говорят о нашем GEO-аудите
Ответ формирует сама нейросеть.
Как считают плотность упоминаний конкурентов
Плотность упоминаний конкурентов — счёт событий, а не доля ответов. Событие — каждое текстовое называние отслеживаемого игрока; в одной сводке их набирается несколько: компании перечисляются списком. Поэтому показатель бывает больше всей выборки ответов. Ошибки нет: деление событий на ответы некорректно.
В том же отчёте соседствуют похожие показатели: доля ответов с упоминанием и доля структурной отметки. Числа близкие, события разные, путаница возникает чаще всего здесь.
Само число событий — не единственная величина. Сырые текстовые совпадения, подтверждённые ручной сверкой упоминания и случаи с одной атрибуцией источника считают порознь; подмена одной величины другой искажает отчёт.
Структурный слой — отдельный учёт сервиса замера: он фиксирует имя, найденное разбором в структуре ответа, а не только текстом. Слои не складываются и технически: присутствие по цитированию исключает ответы, где игрока назвали ещё и текстом. Проверено на каждом отслеживаемом имени среза: поддержку собственным доменом этот слой не показывает.
Чего таким счётом не докажешь:
- сравнения с процентами упоминаний: знаменатель у плотности иной, общей таблицы не выйдет;
- прогноза: срез снят на своей панели и на свою дату, следующий замер способен дать иной состав;
- причины: отчего круг соперников здесь шире, данными не объясняется, домыслов мы не добавляем.
Уровни, скрытые за фразой «конкурент есть в ответах», разбирает анализ конкурентов в AI-выдаче — там же видно расхождение ступеней автоматического прогона и ручной проверки.
Отметка «назвали» и то, что она прячет
Двоичная отметка складывает в одну клетку две разные ситуации: компания названа единственной — или её имя затерялось в длинном перечне. Сводной таблице обе дают по единице, владельцу сайта — разные исходы.
Внутри перечня названия стоят по-разному. В том же B2B-замере у части игроков имя в тексте шло вместе с их сайтом в источниках; другого окружали отраслевые издания, свой домен появлялся редко. Совместная встречаемость причинности не задаёт ни в какую сторону. Работа от этого зависит: имя при собственном материале и имя при чужой публикации требуют разного.
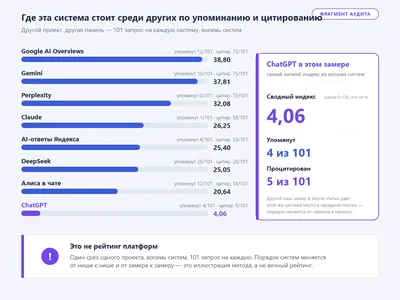
Узнаваемость названия и цитирование домена тоже считают порознь, и в замере по локальной сервисной компании они разъехались: имя звучало часто, домен попадал в источники заметно реже. Большинство систем того замера дало обратное соотношение. Хуже или лучше соседей платформа от такого разворота не становится: разворот принадлежит срезу и дате. В B2B-разборе те же слои у неё почти сошлись.
В том замере внешние адреса сводок образовали общий рыночный контур — каталоги, справочники, карты, отраслевые издания, — и почти весь пул цитируемого не принадлежал ни клиенту, ни отслеживаемым игрокам.
Упоминания бренда в DeepSeek поэтому читают вместе со списком тех, кто назван рядом, и со слоем источников: три величины, три отдельные строки отчёта.
Какие слои тут поддаются замеру
Наблюдаемое по этой системе укладывается в пять строк со своим способом съёма и границей применимости.
| Слой | Чем снимается | Что из него не выводится |
|---|---|---|
| название компании в тексте | разбор ответов по своей панели | рекомендация и порядок предпочтения |
| свой домен в перечне источников | список процитированного рядом со сводкой | факт прочтения страницы человеком |
| соседи по той же сводке | сверка со списком отслеживаемых игроков | доля рынка и доля голоса без знаменателя |
| обращение к сети перед сборкой | счётчик в технических данных | сами поисковые формулировки |
| сводная оценка видимости | составной индекс сервиса замера | пересчёт из упоминаний и цитирований |
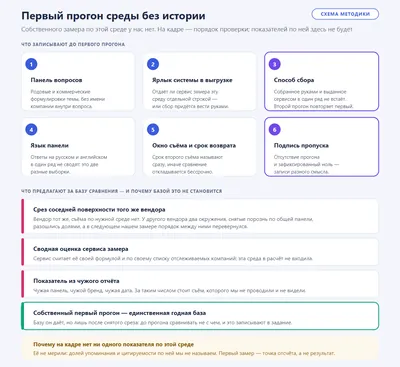
Ограничения жёсткие. Вопросы в панель подбираем мы, за её краем ничего не измерено. Повторного прогона по этой системе нет, устойчивость перечня соседей неизвестна. Правила отбора источников нам не видны: итоговый состав открыт, глубже наблюдение не достаёт. Клики и решения людей в замер не входили — мерили видимость.
Как это превращается в работу над страницами
К прежнему порядку добавляются пункты, подсказанные густо заселённым ответом.
- выгружать по каждому вопросу полный состав названных компаний — без него отчёт теряет половину содержания;
- отсортировать вопросы по длине перечня соседей: верх такого списка образует зону работы;
- склеивать поддомены и вторые площадки одной компании в единую сущность: раздельное сложение завышает счёт соседей;
- держать состав отслеживаемых игроков полным: отключённый из учёта домен в этот слой не входит вовсе и остаётся виден только в журнале цитирований;
- вести источники отдельным учётом — домен бывает опорой и без упоминания имени;
- проверить по каждому вопросу наличие страницы, закрывающей его целиком;
- при повторе замера сохранять ту же панель и тот же состав систем, иначе сравнивать окажется нечего.
Отдельная часть работы — нарезка контента. Законченный фрагмент в длинной главе без подзаголовков машине недоступен: тема раскрыта, извлекать нечего. Границу осмысленного фрагмента задаём своей эвристикой и так её подписываем — сторонним порогом она не становится. Тот же проход снимает мелочи, гасящие извлечение: подписи к картинкам, объявленный язык страницы, разметку вопросов.
Видимость сайта в DeepSeek упирается в тот же материал, что и у соседних платформ: страницы, пригодные к цитированию. Какие площадки попадают в перечни цитируемого, разобрано в статье про источники нейросетей.
Спросите нейросеть о нашем GEO-аудите
Картина соседства вместо отметки
Аудит сайта под DeepSeek выдаёт четыре отдельные строки: название компании в тексте, перечень названных рядом, слой источников, зафиксированный выход в сеть. Сведённые к одной отметке, строки теряют главное — длину перечня.
Видимость бренда в DeepSeek читается по этому списку, а он у каждой компании свой: по соседнему бизнесу не угадывается. За этим и нужен анализ AI-видимости: он называет соседей по каждому вашему вопросу и показывает, чьи домены процитированы.
Вопросы, которые задают после такого отчёта
Наше текстовое упоминание и цитирование домена конкурента — сравнимые величины?
Нет, это разные слои учёта. По своему бренду фиксируют и текст, и попадание домена в источники; по отслеживаемым игрокам — преимущественно цитирование. Строка «мы отстаём», собранная из двух таких чисел, не измеряет ничего.
Текстовая узнаваемость в этой системе оказалась среди высоких. Это её свойство?
Нет. Другая ниша поставила её в самый низ ряда. Порядок систем от замера к замеру меняется, устойчивого места этой системе он не даёт.
Длинный перечень соседей — плохой результат?
Сам по себе никакой. Счёт событий сообщает, сколько имён прозвучало рядом, и умалчивает про вес. Смысл он обретает возле слоя источников и даты съёма, иначе выйдет утверждение о рынке — такого замер не делал.
Видно ли по отчёту, кого система советует?
Названный игрок — ещё не рекомендованный. В B2B-разборе тональность почти всегда оказывалась нейтральной: похвала и упрёк встретились единицами, система перечисляет компании и оценок не выносит. Длинный перечень читают составом сводки; чьим-то выигрышем он не становится.
 GEO-аудит сайта для Claude: анализ видимости и цитирования
 GEO-аудит сайта для Google AI Mode: видимость бренда, источники и AI-выдача
 GEO-аудит сайта для ChatGPT: видимость, упоминания, цитирование и конкуренты
 GEO-аудит сайта для Gemini: анализ видимости бренда и источников
 GEO-аудит сайта для Perplexity: видимость, источники и цитируемость
 GEO-аудит сайта для Алисы и Яндекс AI-поиска
 GEO-аудит сайта для Google AI Overviews: видимость, цитирование и источники
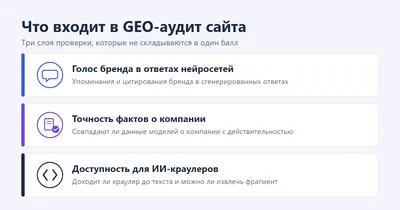 Что входит в GEO-аудит сайта и что он показывает
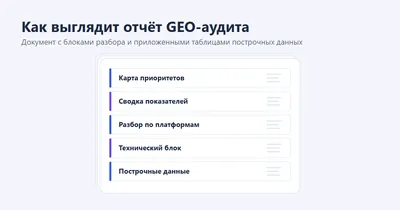 Пример GEO-аудита сайта: как выглядит отчёт по AI-видимости
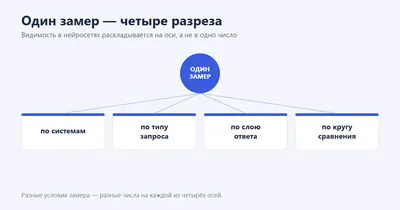 AI Visibility сайта и бренда: как измеряется видимость в нейросетях