GEO-аудит сайта для ChatGPT: видимость, упоминания, цитирование и конкуренты
Что показывает GEO-аудит по ChatGPT: чем эта система непохожа на соседние, как устроен обход сайта её агентами и почему сайта может быть не видно.

Коротко
- Аудит по ChatGPT считает три слоя порознь: названо ли имя компании в тексте, попал ли её домен в источники ответа и кто из конкурентов оказался рядом.
- В наших прогонах устойчиво повторился только низкий сводный индекс этой системы. Текстовые упоминания колебались от проекта к проекту, поэтому постоянного рейтинга площадок из таких данных не выходит.
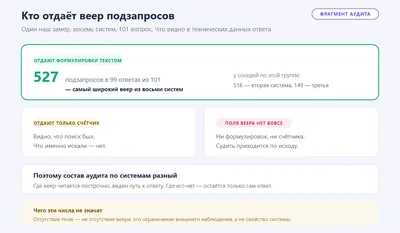
- В отличие от Google AI Overviews, Gemini и AI-ответов Яндекса, ChatGPT не отдаёт наружу формулировки вспомогательных запросов — виден только счётчик факта поиска. Это ограничение наблюдения, а не признак отсутствия поиска.
- Сайт обходят боты с несовпадающими задачами, и различить их можно только по журналам сервера: разрешение в robots.txt, фактический визит и фактическое чтение текста — три разные вещи.
- В одном прогоне robots.txt разрешал всех краулеров, но сервер отвечал им по-разному: агенты реального времени получали страницу, обучающий краулер — нестандартный отклик. Причину журналы не объясняют.
GEO-аудит для ChatGPT разводит три слоя: прозвучало ли имя компании текстом, стал ли домен источником ответа, кто из конкурентов очутился рядом. Устойчивую картину наши прогоны дали лишь по сводному индексу — его выводит сервис замера, и эта система держала индекс возле самого дна списка. Текстовая узнаваемость вела себя неровно, поэтому рейтинг отсюда не выводится. Дальше — чем манера ChatGPT отличается от соседских, что разбирают поодиночке.
Что показывает аудит по этой платформе
Срезы считают врозь, свести их одним числом невозможно: узнаваемость бренда, цитируемость домена, состав конкурентов отвечают на разные вопросы. Встречается ссылка на страницу без имени компании; случается обратное — имя прозвучало, а опора пришлась мимо материалов самого владельца, на общий рыночный контур. Смысл каждой величины объясняет разбор AI-видимости; измеряет их аудит под AI-поиск — прицельно, по одной системе.
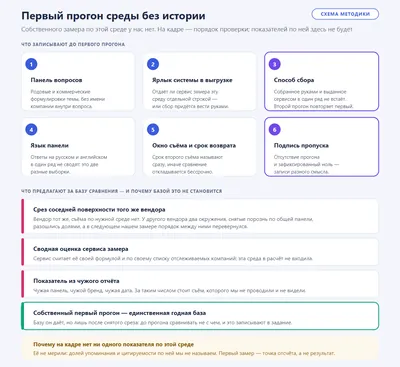
Первенства наши прогоны этому сервису ни разу не принесли. Сводный индекс лежал возле дна, а текстовое упоминание прыгало: на одном проекте едва отличалось от нуля, на другом поднималось заметно выше. Отсюда главная оговорка: порядок систем меняется от ниши к нише и от даты к дате, вечный рейтинг таких строк недостижим.
Сводную оценку вдобавок считает сервис замера по своей формуле — простая арифметика её не даёт. Низкий композитный балл сам по себе поломку прячет, он лишь повод разбирать измерения врозь. Устойчиво повторилось другое: соотношение двух измерений, о нём ниже.
Узнайте, что нейросети говорят о нашем GEO-аудите
Ответ формирует сама нейросеть.
Чем эта платформа непохожа на соседей
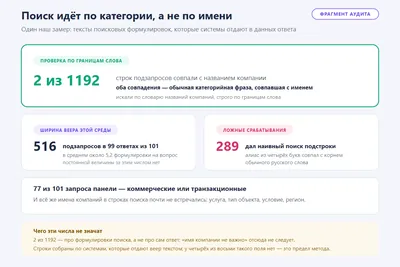
Различие прячется в пути к ответу — сам он выглядит обыкновенно. Google AI Overviews, Gemini и AI-ответы Яндекса сохраняют в технических данных подлинные формулировки вспомогательных поисковых запросов: веер, из которого сложилась реплика, читается построчно. Здесь формулировок нет, наружу выходит лишь счётчик — отметка о состоявшемся поиске. Отсутствия веера отсюда не следует, это ограничение внешнего наблюдения: подзапросы снаружи неразличимы, судить приходится по результату.
Счётчик, впрочем, полезен и сам: он фиксирует факт поиска. Значит, ответы с поиском отделимы от собранных без него, по памяти. Дальше остаётся мерить исход — какие адреса очутились в перечне цитируемого. Так и построен вывод в отчёте: вместо восстановления веера — опись действительно процитированного. Гадать о внутренней механике бессмысленно, такая догадка неуместна.
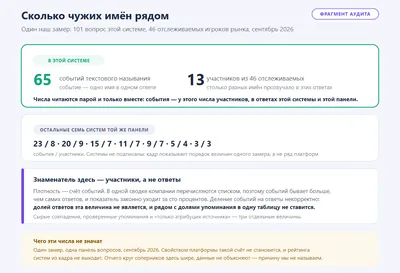
Второе отличие — согласованность. Домен цитировали чаще, чем называли компанию, — подобно большинству соседей, однако разрыва между двумя срезами не возникло: оба показателя оседали дружно. Часть соседних ассистентов рисует картину резче — ресурс служит опорой нередко, название звучит крайне редко; разъезда такого размаха здесь не было. Что первично — отсутствие адреса в перечне или неузнаваемость названия, — логи и выгрузки молчат.
Что аудит проверяет отдельно
Проверки разведены:
- узнаваемость названия текстом — отдельно от присутствия домена в списке ссылок;
- состав источников вокруг запроса: свои публикации, публикации конкурентов, прочий рыночный контур;
- окружение соперников в той же сводке — кто из отслеживаемых игроков встал рядом с брендом или вместо него.
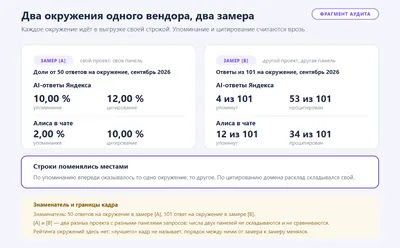
Каждый пункт считают на собственной панели запросов и на собственную дату. Перенос итога на чужую нишу или другой месяц даёт ошибку.
Про соперников есть отдельная тонкость. Присутствие игроков распределено по средам крайне неравномерно: где-то почти весь отслеживаемый список обнулялся. Упрёк «соперник опережает нас в генеративной выдаче» без указания среды повисает в воздухе — список победителей у каждого свой.
Как устроен обход сайта у этой платформы
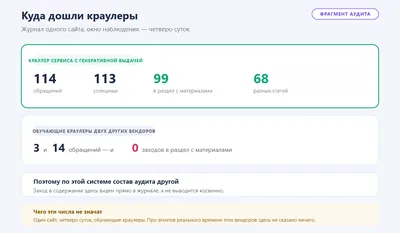
Обход ведут несколько ботов с разными задачами: один копит материал для обучения модели, прочие обращаются к странице в реальном времени — запросом системы либо просьбой человека открыть ссылку. Имя бота в журнале доступа обычно выдаёт задачу, поэтому сборщик обучающего корпуса отличим от поискового.
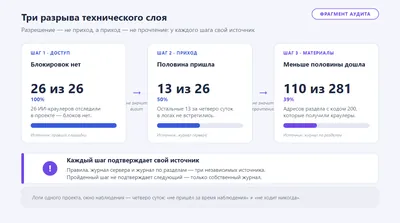
Записанное разрешение, фактический приход краулера, фактическое чтение содержимого — три несхожие вещи, журнал разделяет их построчно. Он же единственная опись, где видно поштучно: кто пришёл, когда, какой документ забрал, чем кончилось. Панельный замер этого не покажет — он описывает исход, а не визит.
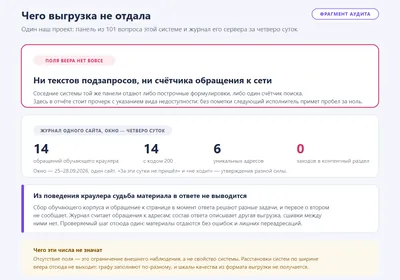
Поведение в боевых логах разошлось далеко. Обучающий краулер заглядывал редко, раздел со статьями миновал вовсе: его след остался за пределами содержательных публикаций. Агент реального времени приходил чаще, однако статьи собрали меньшую часть его обращений; куда ушла остальная, по выгрузке неясно. Робот соседней среды в том же окне наблюдения тянулся к статьям заметно охотнее.
Другой прогон добавил деталь. Файл robots.txt разрешал всех проверенных краулеров, а сервер всё равно отвечал по-разному на один и тот же адрес: агенты реального времени получили обычный документ, обучающий краулер — нестандартный отклик. Вывод о невидимости ресурса отсюда неправомерен: живым агентам материал достался целиком. Причина расхождения из журналов неясна — перед нами фиксация факта, а не диагноз.
Почему ChatGPT «не видит» сайт
Видимость проседает сразу по нескольким причинам, и решающая пока неизвестна — каждая просто сопутствует прочим.
Первая — конкуренция за место в перечне источников. Ссылок обыкновенно много, однако нужный адрес оказывается среди них нечасто, а механика отбора снаружи невидима.
Вторая — глубина обхода. Когда роботы ограничиваются статичными разделами, минуя публикации с прямым ответом, подходящий для цитаты фрагмент до системы не доходит.
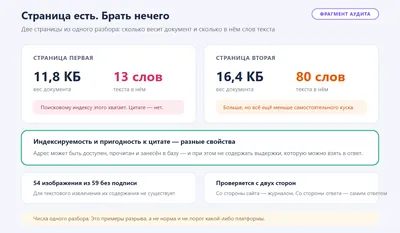
Третья — технические помехи, не связанные с одной платформой: нестандартные отклики сервера, тяжёлые документы, съедающие лимит обхода, закрытые правила доступа. Особая уязвимость здесь не обнаружилась, но общие помехи сопутствуют первым двум причинам. Наш случай показателен: разрешительный robots.txt соседствовал с разным поведением сервера, политика площадки и фактическая отдача материалов — вещи независимые.
Спросите нейросеть о нашем GEO-аудите
Вывод
Аудит дробит картину: упоминание бренда, выбор источников, визиты роботов — поодиночке, и разрыв чаще всего обнаруживается на стыке. Итог одного проекта на другой не переносится: вместе с любым показателем называют систему, нишу и дату.
Если неясно, какой слой проседает именно у вас, оценить видимость бренда в AI-ответах стоит по собственной панели запросов, а не по чужому примеру.
Вопросы и ответы
Если бренд не звучит в тексте ответа, значит ли это, что сайт не виден вообще?
Нет. Узнаваемость имени, цитируемость ресурса считают отдельно: домен бывает опорой реплики, где компания безымянна. Здесь оба слоя шли рядом, часть соседей разводила их далеко — смотреть стоит оба.
Стоит ли проверять эту платформу саму по себе, если итог почти всегда ниже соседей?
Как раз поэтому. Низкая сводная оценка умалчивает, где поломка, а поломки тут бывают несхожие. Вдобавок композитный балл и текстовое упоминание ведут себя несогласованно, усреднять их бессмысленно: первое проседает, второе гуляет.
Чем видимость сайта в ChatGPT отличается от обычной выдачи в поисковике?
Выдача показывает позиции страниц, а здесь читают готовую реплику: имя прозвучало, домен процитирован опорой либо отсутствует и то и другое. Позиции обычного поиска на эти измерения не переносятся — бывает, с поиском всё ровно, реплика его минует.
Можно ли узнать, заходил ли на сайт робот этой платформы?
Да, по журналам сервера: там остаются записи с именами ботов. Без логов визиты невидимы: панель поисковика и штатная аналитика их пропускают.
 GEO-аудит сайта для Gemini: анализ видимости бренда и источников
 GEO-аудит сайта для Perplexity: видимость, источники и цитируемость
 GEO-аудит сайта для Алисы и Яндекс AI-поиска
 GEO-аудит сайта для Google AI Overviews: видимость, цитирование и источники
 GEO-аудит сайта для DeepSeek: анализ видимости и упоминаний
 GEO-аудит сайта для Claude: анализ видимости и цитирования
 GEO-аудит сайта для Google AI Mode: видимость бренда, источники и AI-выдача
 Технический GEO-аудит сайта: что проверить перед продвижением в нейросетях
 Как увеличить видимость сайта и бренда в нейросетях
 Аудит сайта для LLM и AI Search: что проверять для генеративного поиска